用四个 LLM 组队解一道组合题
取一个 16×16 的单位方格网格。在上面摆放轴对齐的矩形,使得每一行、每一列都恰好留下一个未被覆盖的方格。最少需要多少个矩形?
单个 agent 往往会以一种自信的方式答错:它找到一个构造、说服自己相信了某个匹配的下界、然后写出一份干净、自洽、但错误的答案。我们改把它跑在 future-loop 多智能体控制平面上——四个不同的模型并行工作,外加一个只协调、被禁止求解的编排者。答案是 21。有意思的是系统是怎么走到那一步的。
编排者什么都不解
整个运行由 future-loop 驱动——FutureOS 的多智能体工作控制平面。用户给编排者的提示以一条硬约束结尾:本会话内不要做任何求解。编排者的工作被限定为:分解任务、调度 worker、裁决结果、维护证据账本。全部数学都发生在 worker 会话里。
有几个机制承担了重量:
- 目标与工作卡。 任务被拆成卡片,每张有优先级、依赖和唯一属主。一卡一 worker,所以并行 worker 抢不到彼此的活。
- Verify 闸门与证据。 每个交付卡绑定一条 shell 命令(比如
test -s <报告路径>)和一条非空证据备注。当 worker 声称完成时,控制平面自己跑这个闸门;失败则不接受。 - 共享板。 worker 只能往一个共享文件里追加简短结论(3–5 行)——这是唯一的跨 worker 广播通道。每个 worker 还有自己的产物目录,所以没人覆盖别人。
- Steer。 编排者可以随时向 worker 注入一条指令。我们用它救回过一个跑了 40 分钟什么都没写盘的 worker。
- 故障恢复。 基础设施故障(比如上游断连)被标记为可恢复:会话保留、上下文重放、运行恢复——不消耗这次运行的错误预算。
在任何 worker 启动前,编排者把共享记法和协作协议写进了 PROBLEM.md——怎么标记一个洞、瓷砖坐标格式、验证脚本必须做什么——这样任何 worker 的结果都能被其他 worker 重跑。这条「先定协议,再干活」的纪律,事后证明很关键。
问题
因为每行每列恰好有一个未覆盖方格(一个洞),这些洞是 U = {(r, π(r))},其中 π 是 {1..16} 的某个排列。瓷砖是不含洞的矩形。对固定的 π,记 τ(π) 为恰好铺满「棋盘减去洞」的最少瓷砖数。答案是 k* = min over π of τ(π)。
四个模型当 worker:glm-5.3-flash(审计 / 反例)、deepseek-v4-pro(证明 / 构造)、kimi-k3(构造搜索)、gpt-5.6-sol(独立探索、反思、终审)。它们还有真正的求解器:Z3、OR-
时间线
运行从 22:05 到 02:34,墙钟 269 分钟,15 轮。
| 阶段 | 时间 | 发生了什么 |
|---|---|---|
| 并行探索 | 22:05–22:49 | 四个 worker 全部启动。gpt(low) 用对角线构造 2.1 分钟给出 k = 30;deepseek 得到 k = 23;kimi 用精确小值(n = 4..7 得 5、7、8、10,全低于 2n − 2)证伪了普适下界并得到 k = 22;glm 超时且盘上无物,被 steer 拉回后复现了 k = 30。 |
| 交叉反思 | 23:00–23:04 | gpt(high) 重跑全部四个验证器并裁决:k = 30 的引理和 k = 23 的公式都被 k = 22 的反例击杀。状态收紧到 15 ≤ k* ≤ 22。 |
| 第二轮 | 23:06–23:57 | deepseek 找到 4×4 网格排列构造,k = 21 并提出一个引理;gpt 的联合 SMT(排列不固定)独立找到同一构造的镜像,并证明 n=16、k=20 不可满足(221 秒);kimi 用精确 ILP 证明这个排列恰好需要 21;glm 交叉复现了全部小情形精确值。 |
| 对抗性终检 | 00:09–02:19 | kimi:57,897 个精确 ILP 实例(含完整的 2-swap 邻域)在 k ≤ 20 上零命中;deepseek 把引理的分解与归纳形式化;gpt:CP- |
| 终审 | 02:28–02:34 | gpt(high) 重跑关键验证器并真的重跑了 CP-SAT(再次 INFEASIBLE,94 秒),写出最终报告,目标闭合验证环。 |
答案是 21
构造使用排列 π(r) ≡ 4r (mod 17):
π = 4, 8, 12, 16, 3, 7, 11, 15, 2, 6, 10, 14, 1, 5, 9, 13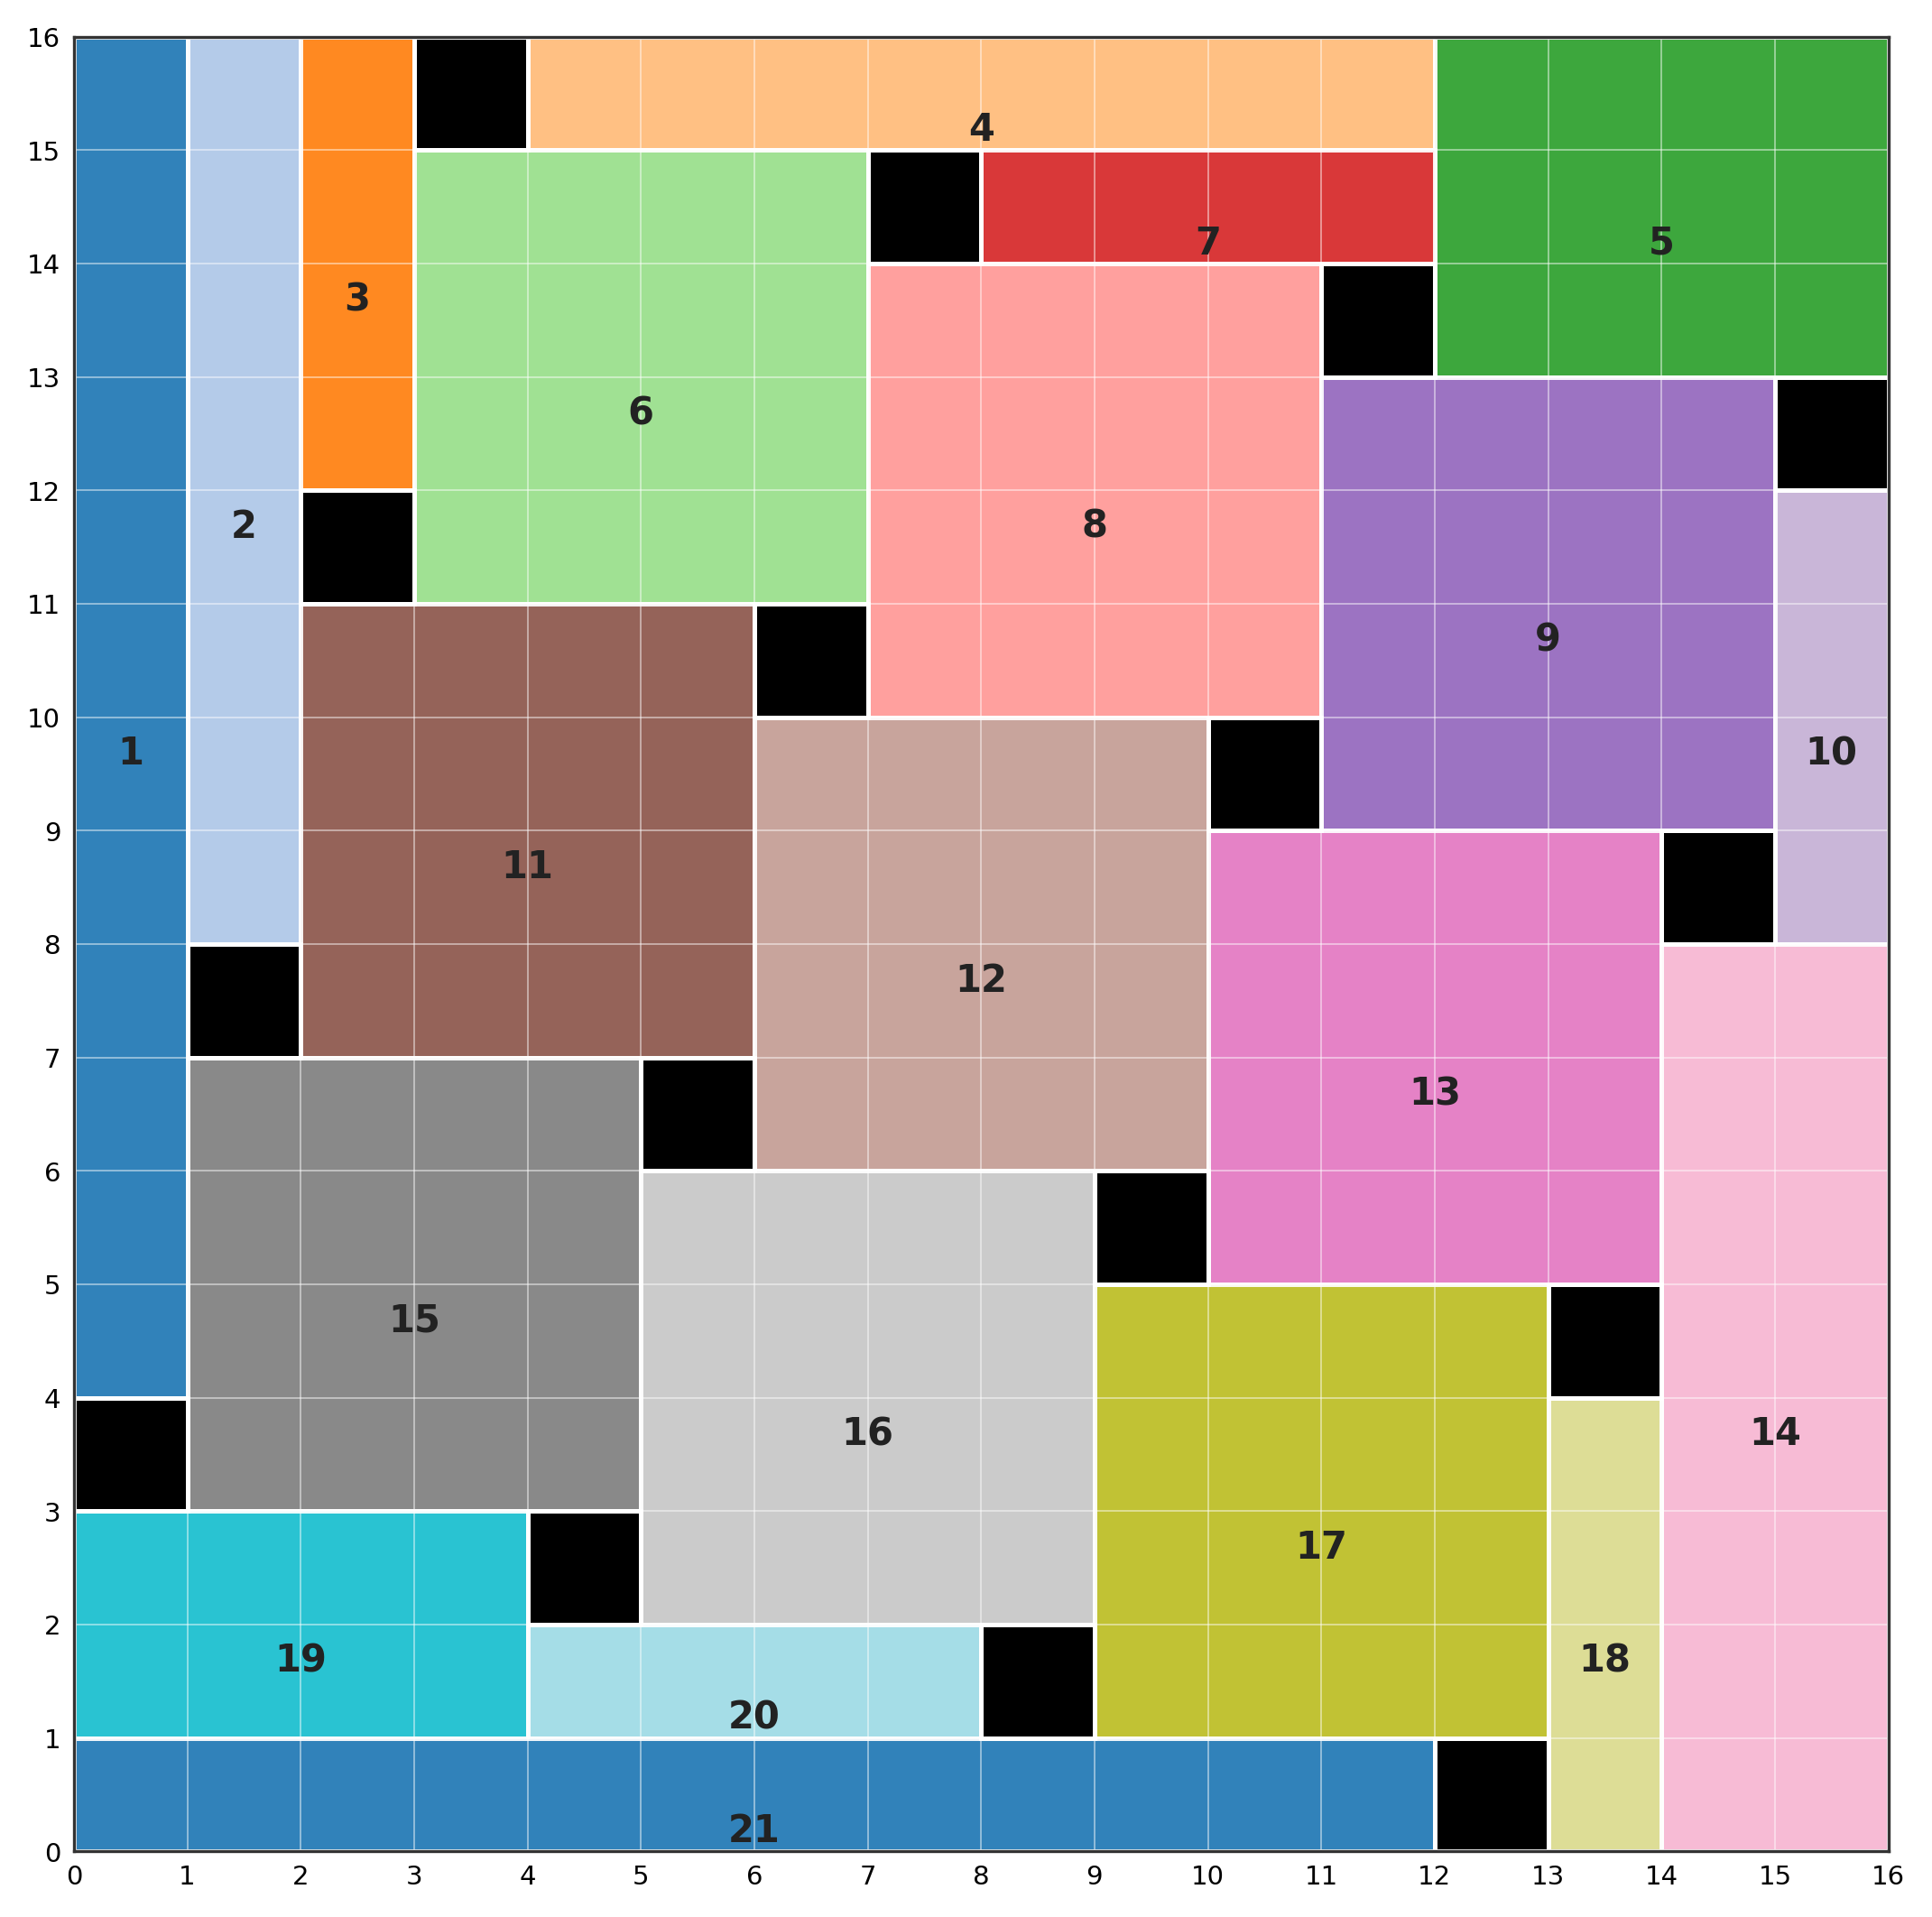
图 1:最优铺法。黑色格是 16 个洞(每行每列各一个);彩色编号区域是 21 块瓷砖。
这给出 k* ≤ 21。下界方面,一个结构性引理把瓷砖数与排列的最长上升子序列和最长下降子序列(LIS / LDS)挂钩:τ(π) ≥ n + LIS(π) + LDS(π) − 3。由 Erdős–Szekeres 定理 LIS·LDS ≥ n,所以 n = 16 时 LIS + LDS ≥ 8,引理给出 τ(π) ≥ 16 + 8 − 3 = 21 对每个 π 成立。该引理的分解与归纳步骤已完全形式化;基例(简单排列的闭式见证集)仍未闭合,不过已对 n = 8 以内全部 48,232 个排列、以及 n = 16 的特定平衡排列做了计算确认。
妙处在于,这个引理的记账方式解释了此前每一个错误答案。对角排列 LIS=16, LDS=1,下界 16+16+1−3 = 30——恰好是它的构造。洗牌排列 LIS=8, LDS=2,下界 16+8+2−3 = 23——又是恰好。唯一能做得更好就是让两者平衡,而 4×4 网格让 LIS = LDS = 4,同时命中 Erdős–Szekeres 界和引理界。上界与下界在同一个排列上相遇。
独立于数学本身,两个精确编码——Z3(QF_
花了多少
| 阶段 | 模型(强度) | 时间(分) | 输入 tok | 输出 tok | 成本 |
|---|---|---|---|---|---|
| 探索 | gpt-5.6-sol (low) | 2.1 | 170,499 | 4,865 | $0.78 † |
| 探索 | deepseek-v4-pro (high) | 34.0 | 2,453,301 | 108,580 | ¥1.91 |
| 探索 | kimi-k3 (high) | 44.4 | 622,961 | 74,681 | ¥19.93 |
| 探索 | glm-5.3-flash (high) * | 48.5 | 135,763 | 43,868 | ¥0.09 |
| 反思 | gpt-5.6-sol (high) | 3.9 | 431,109 | 9,080 | $1.91 † |
| 第二轮 | glm-5.3-flash (high) | 27.3 | 438,737 | 60,207 | ¥0.15 |
| 第二轮 | deepseek-v4-pro (high) | 43.9 | 3,289,309 | 130,402 | ¥2.38 |
| 第二轮 | kimi-k3 (high) | 48.9 | 865,052 | 16,195 | ¥18.92 |
| 第二轮 | gpt-5.6-sol (high) | 51.5 | 1,181,143 | 15,773 | $5.04 † |
| 第三轮 | kimi-k3 (high) | 27.9 | 985,814 | 14,915 | ¥21.21 |
| 第三轮 | deepseek-v4-pro (high) | 35.0 | 3,131,360 | 124,650 | ¥2.36 |
| 第三轮 | glm-5.3-flash (high) | 38.8 | 542,528 | 52,202 | ¥0.15 |
| 第三轮 | gpt-5.6-sol (high) | 129.6 | 1,955,548 | 30,218 | $8.43 † |
| 终审 | gpt-5.6-sol (high) | 5.5 | 805,660 | 10,619 | $3.44 † |
| 合计 | 4 模型 / 15 轮 | 571 串行 / 269 并行 | 17,008,784 | 696,255 | ¥67.08 + $19.5–38.5 † |
† gpt-5.6-sol 按推广价估算;其余为实际计费。* glm 第一轮超时零输出,被 steer 拉回。
有三点很醒目。最快的答案最差——gpt(low) 2.1 分钟给出 30,而最慢的链条才是有价值的。大部分墙钟花在求解器子进程和大规模枚举上(约 2.9 小时),LLM 推理只占小头——这正是你想要的形态:模型时间花在思考上,墙钟花在计算上。还有 kimi-k3 扛了最重的 ILP 编排(占国产模型成本的 81%),但两次决定性突破——证伪 30、以及最终的零命中验证——都是它的。
有人作弊吗
三层审计,都留有可复核的痕迹:
- 工具层: 15 次运行里 worker 只用了 read / shell / write / edit。网络搜索、抓取、浏览器调用:零。
- 参数层: 每个 worker 的转录都被扫描过 curl/
wget/ requests/ urllib/ httpx/ socket、搜索引擎与问答关键词、外部 URL。唯一的网络活动出现在第三轮的一个会话里—— brew install kissat、git clonedrat-trim、pip install ortools——装本地求解器,不是查答案。 - 产物层: 最终构造与下界的每一部分都能追溯到 worker 生成的脚本与输出(验证器、带 SHA-256 的 SMT2/CNF 文件、57,897 条 ILP 日志)。
至于「模型会不会只是记得答案」:不能绝对排除,但四个模型第一轮给的是 30、23、22、30——记下来的答案会趋同。两个 21 块构造是被两个看不到彼此目录的模型独立找到的,互为镜像、带完整合法铺法。而且最终答案由穷尽的本地计算(UNSAT 和 ILP)锚定,而不是任何模型的一面之词。
为什么多智能体在这里有用
答案从 30 → 22 → 21,每一次下降都来自一个与其他模型不同的分歧,而不是哪个模型想得更狠。一个认定「对角线 + 30」、配上自洽错误下界的单个 agent 会把错误答案交付出去。打破它的是 kimi-k3 的小情形反例,然后是 deepseek 为第二次突破做的排列平衡。
两个被独立找到的 21 块构造——一个用 ILP、一个用 SMT,编码和求解器都不同、互为镜像、之后又被 CNF/Kissat 第三次复现——是最强的那种交叉验证。对抗式分工意味着「找 21」和「证 21」同时沿四条路线被攻击(构造搜索、数学下界、计算排除、方法审计),彼此校验。
工程上,verify 闸门把「声称完成」变成「验证完成」:15 个里 13 个通过、1 个被闸门挡住(工作在下一轮补齐)、1 个出错进入失败又恢复。终审者重跑而不是相信摘要。并行把墙钟从 571 压到 269 分钟——约 2.1×。
诚实的告诫
探索型 worker 需要一条「定期存档到磁盘」的约定——glm 第一轮空转 39.5 分钟什么都没写。编排者犯了两个记账错误(一个卡片类型设错、一个依赖指错),都被机制抓到并纠正。kimi 第二轮没过 verify 闸门,它的结果一度不可见。没有便宜的第二梯队来卸载重型搜索。还有 n=16 的机器可检查 DRAT/LRAT 证书没闭合——这是剩下的最大形式化缺口。
小结
一个带闸门的多智能体编排可以端到端解一道中等规模的组合优化题:四个异构模型在 4.5 小时里把答案从 30 降到计算穷尽的 21,全程可审计、可复现。上界是一个严格验证过的构造;下界依靠两个求解器独立排除 20;引理的分解与归纳已证明。补上结构引理的基例、或产出 n=16 的 DRAT/LRAT 证书,都能把这变成一个干净的定理或一份完全形式化的证明——两者都是具体的下一步目标。
完整案例(含完整瓷砖坐标、复现脚本和参考文献)是本文的来源;编排机制是 future-loop,FutureOS 的 loop 控制平面。