本地模型已经够用:质量差 3 分以内,墙钟 2.5–5.5 倍
在本地跑模型,过去是一个以质量为代价的隐私方案。这一代模型把这个取舍收窄到了可以直说的程度:日常使用,本地模型已经够用。我们做了测量——25 组配对任务、四个场景、同一提示词、一个更强的独立评审——这是总账:
- 质量:100 分制 89.5 对 92.6(本地对云端),12 项套件各赢 6 项;
- 完成度:两边全部编码运行全绿——10/
10 次 agentic 运行全绿(20/20 可见测试、4/4 隐藏检查、测试文件未改动),bug 修复循环两边各 5/5 轮、修出的 4 个 bug 完全一致; - 速度:墙钟 2.5–5.5 倍,随场景浮动;本地耗时 95% 以上花在模型生成上;
- 成本:本地只花电费。12 项套件的云端一侧合计 0.14 积分。
不是打平。落后 3 分——而且这 3 分并非处处均匀,它们有聚集的地方。但对一个每天都要做的决定来说,"落后"不是正确的框架:这台机器接不接得住活?就我们实测的工作负载,接得住。
对比的是什么
两个模型经由同一个 agent 回答,只差一个参数:
- 云端:
deepseek-flash,我们 agent 的默认模型; - 本地:Qwen3.8-
27B,4- bit(oQ4e)量化、启用 MTP,跑在 Mac Studio(M3 Ultra / 96 GB 统一内存)上,经 omlxprovider 提供服务。
四个工作负载:
| 场景 | 形态 | 重复数 |
|---|---|---|
| 质量套件 | 12 个短任务:格式遵循、JSON、逻辑、数学、代码调试、长上下文检索、事实性、翻译、否定约束、中文语义、创意写作、安全 | 12 任务 × 2 模型 |
| bug 修复循环 | 小项目、4 个植入 bug、10 个测试;跑测试 → 定位 → 修复 → 复跑 | 5 轮 × 2 |
| agentic 编码 | 4 个模块、7 个交互 bug + 1 个未实现功能;20 个可见测试(18 个失败)、4 项隐藏语义检查;必须迭代 | 5 轮 × 2 |
| 深度调研 | 深度 B 契约:20–40 个去重来源、学术占比 ≥40%、论断经来源核实、完整报告 | 3 轮 × 2 |
所有对比共同遵守的规则:每组配对同一提示词、同一 thinking 档位;墙钟端到端计时(长任务以 agent 自身的运行记录为准,而不是 CLI 返回的时刻);质量由 Kimi K3 盲评——一个比两位被测者都强的模型——100 分制,配对匿名化、两种呈现顺序交替。
墙钟:2.5–5.5 倍
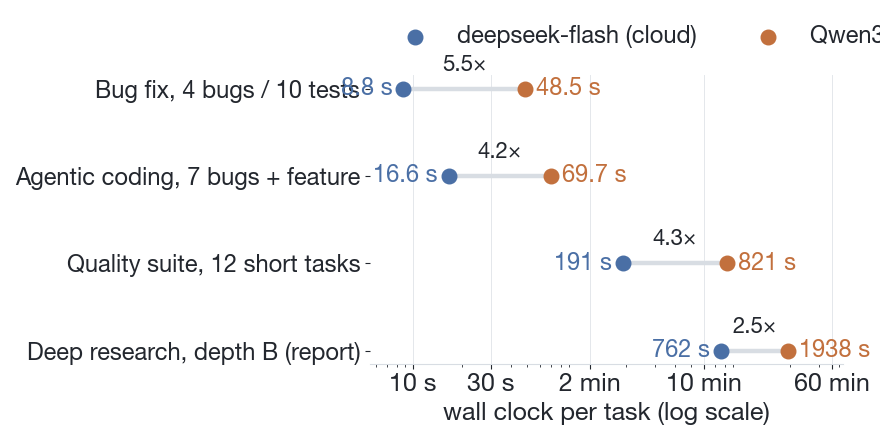
每个任务的墙钟,对数刻度。同样的提示词、同样的工具;本地多出来的时间几乎全是模型生成。
| 场景 | 云端 | 本地 | 倍数 |
|---|---|---|---|
| 质量套件(12 任务合计) | 191 s | 821 s | 4.3× |
| bug 修复循环(5 轮均) | 8.8 s | 48.5 s | 5.5× |
| agentic 编码(5 轮均) | 16.6 s | 69.7 s | 4.2× |
| 深度调研·深度 B(3 轮均) | 12.7 min | 32.3 min | 2.5× |
倍数不是常数——它是任务构成。把每次运行拆成模型时间和工具时间,图景是一致的:
- 小型编码场景里,工具调用是近乎即时的文件读取和测试执行;两边墙钟的约 95% 以上都是模型生成,于是倍数逼近纯生成倍数(≈5×);
- 调研场景里,云端花在工具上的时间更多(抓取的来源更多——报告也因此更好),把端到端倍数稀释到了 2.5×。工具时间是两边共享的;只有生成时间不同。
调研运行里还藏着一个实际数字:本地模型产出报告用了 65 轮,云端用了 41 轮。更多地轮次叠加更慢的速度,方向一致地放大差距。
质量:3 分,6 比 6
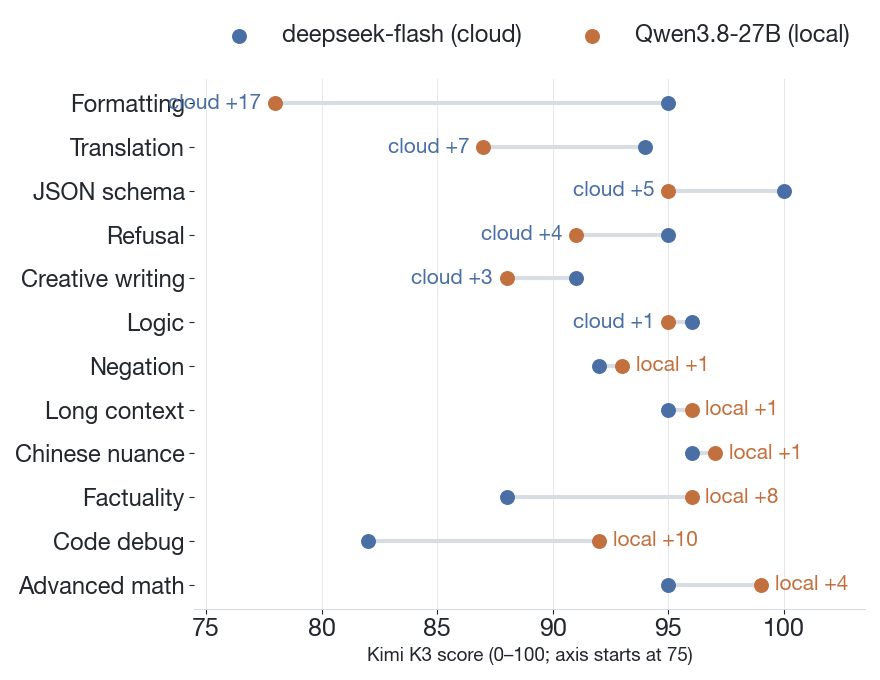
K3 逐项得分,坐标轴从 75 起。12 项 6 比 6;本地赢在推理与事实,云端赢在指令遵循与打磨。
| 类别 | 云端 | 本地 | 差 |
|---|---|---|---|
| 12 项质量套件(均分) | 93.2 | 92.2 | +1.0 |
| 深度调研报告(3 轮均分) | 91.7 | 87.3 | +4.4 |
| agentic 代码质量 | 93 | 89 | +4 |
| 综合(等权) | 92.6 | 89.5 | +3.1 |
综合分掩盖了一个有意思的分裂。12 个短任务里两个模型逐项交换胜负——各赢 6 项。两个方向的最大差距:云端在严格格式上 +17,本地在代码调试上 +
- 本地,格式任务:78 分——它在答案开头多加了两个空行,而任务明确禁止空行。内容本身完美。
- 云端,事实性任务:88 分——让推荐书目,它把一本阿西莫夫的小说写成了不存在的书名(《碎石星空》,正确应为《繁星若尘》)。它没有编造,只是记错了一个名字。
评审模型在两边都找出了我们第一遍人工复核漏掉的真缺陷——这正是用"比被测者更强"的模型做评审的意义。在任何私有基准里我们都建议同样的纪律:评审要用比你自己在测的模型更好的模型。
编码:两边全绿
这是"日常够用"真正被裁决的场景,所以我们把通过门槛设得难以侥幸:
- 7 个 bug 在 4 个模块间交互——单独修好一个会弄挂可见测试;通过条件是 20/20 可见测试;
- 4 项隐藏语义检查(严格边界、大小写归一、默认参数、中间删除),让过拟合可见测试的修法失败;
- 测试文件必须零改动——机器校验。
结果,各 5 轮:
| 指标 | 云端 | 本地 |
|---|---|---|
| 可见测试 20/20 | 5/5 轮 | 5/5 轮 |
| 隐藏检查 4/4 | 5/5 轮 | 5/5 轮 |
| 测试文件未改动 | 5/5 轮 | 5/5 轮 |
| 轮次 / 工具调用(均值) | 7.8 / 18.4 | 6.6 / 15.2 |
两个模型收敛到同一套工作流——发现、跑测试、读全部源码和测试、批量修复、复跑、迭代——都修完了全部 7 个 bug 并实现了新功能。而在小型 bug 修复循环里,两个模型在 5 轮中修出的 4 个 bug 完全一致:一致的指令被一致地执行。
盲评代码质量把云端领先 4 分(93 对 89):云端对空输入的处理更统一、逻辑重复更少。这是可维护性上的余量,不是正确性差距——两边没有任何一项失败。
调研:交付 3/3,契约 2/3
深度调研契约要求 20–40 个去重来源、学术占比 ≥40%、论断对来源核实、产出完整报告。全部 6 次运行(每模型 3 次)都交付了报告;两个模型都遵守了诚实规则——不绕付费墙、披露失败引用、冲突数字并列而不是取平均。
把它们区分开的是:
- 广度:云端报告引用 38–40 个来源、学术占比 53–67%;本地 23–37 个、24–52%;
- 契约达标:云端 3/3,本地 2/3——未达的那次学术占比 24%,并且自己说出来了,没有拿博客填充;
- 一处真缺陷:一份本地报告正文引用了 N13–N22 十个来源,参考文献里却没有——引用链断裂,是发布前需要人工检查的那种问题。云端报告则一贯把"已核实论断"和"单一来源论断"分开表述。
这是"够用"最弱的场景:本地调研报告是一份扎实的初稿,需要一轮审校;云端报告更接近可直接发布。如果你的日常工作就是产出调研报告,3 分的综合差距低估了实际差异;报告上 +4.4 的数字更诚实。
等待:速度税到底长什么样
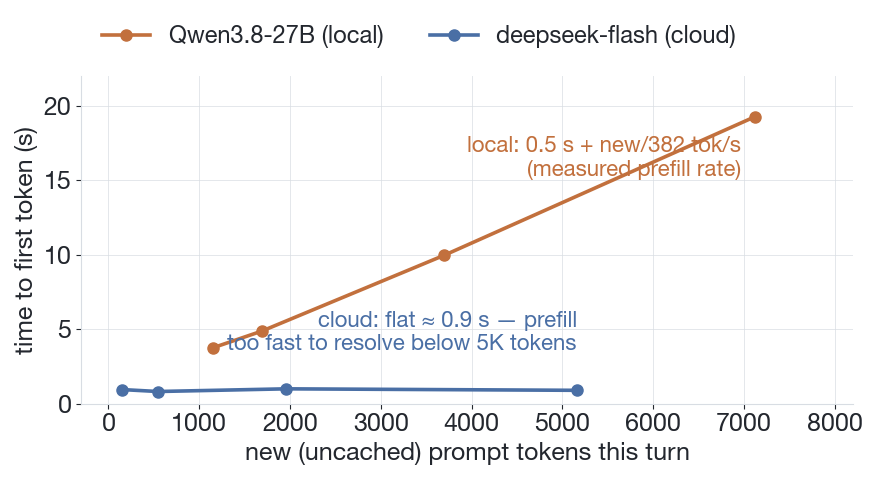
首 token 时间对新(未缓存)token 数。本地的斜率是实测预填充速率 382 token/
墙钟倍数是平均体验;首 token 时间(TTFT)是每个瞬间的体验。在两边缓存都热的多轮会话里重复测量:
- 本地:TTFT ≈ 0.5 s +(本轮新增未缓存 token)/382 token/
s。稳定且有效,斜率就是全部故事:预填充就是 382 token/s,没有别的。 - 云端:5K 新增 token 以内都是 ≈0.9 s 的平线——它的预填充快到这套测量分辨不出斜率。
落到实际:一个每轮新增几百 token 上下文的交互会话(你的消息、一条工具结果、一个 diff),本地模型等 ~1.5–2 s 出首 token,云端 ~1 s——感觉得到,但仅此而已。某一轮一次塞进 7K 新上下文(一个大文件、一段长日志),就是 19 s 对 1 s——这个差距会改变你的工作方式。而且本地的 KV 缓存块粒度是 2048 token,前缀复用回收得少;云端缓存粒度更细、命中更狠。
操作上的结论:本地模型适合增量式的工作方式。上下文缓慢增长的会话始终快,因为命中的轮次跳过了预填充。一次猛灌一个大工件进上下文的会话,为它付一次 382 token/s 的税。
我们什么时候用哪个
同一套工作流、只差一个参数,所以选择只是策略:
- 默认用本地:涉及私密材料的工作、离线工作、不在乎延迟的批量任务、日常编码/
QA 循环。零边际成本意味着你可以直接再跑一遍。 - 留给云端:超出本地 20 万 token 窗口的上下文、广度重要的调研、对延迟敏感的交互。
3 分,外加一笔从几乎无感到改变工作方式的、随任务构成浮动的速度税——这就是把一切都跑在自己机器上、自己房间里的当前价格。它已经低到:本地模型不再是你接受的退路,而是你可以主动选择的默认。