用 Jev 做技能推荐:一次调用、一个阈值、100 道题
FutureOS 有 141 个技能,没人记得住 141 条斜杠命令。所以当草稿明显需要某个技能时,agent 会在输入框上方给出一个——由 Jev 挑选,即 TypeSafe 的 System One 模型,它只对交给它的内容做判断,不写文本。一次调用、一张选项表、一条阈值。我们让一个强生成模型用同一份目录回答同一个问题,对比是:
- 精度:首次命中 90.8% 对 93.8%——只落后三个百分点,而且在运行噪声之内(同一份代码在两次相同运行之间就在 90.8–93.8% 之间浮动);
- 成本:每题 ¥0.0027 对 ¥0.0249——便宜 9 倍;
- 延迟:中位 0.49 秒对 1.75 秒——快 3.6 倍;
- 拒绝:两边正确拒绝都是 97.1%,但 Jev 的是一条可以标定的概率,生成模型的是改不了的 prompt 行为。
| 系统 | 首次命中正确 | 正确拒绝 | 元/题 | 延迟 p50 |
|---|---|---|---|---|
| Jev,一次调用(发布版) | 90.8% | 97.1% | 0.0027 | 488 ms |
| deepseek-flash,同样 prompt | 93.8% | 97.1% | 0.0249 | 1,747 ms |
| 本地向量检索 | 64.6% | 71.4% | 本地算力 | 15 ms |
这就是取舍:原始精度比生成模型略低,成本便宜一个数量级,速度快好几倍,拒绝可审计。
我们从中拿到的两条结论
有两条结论可以推广到这件事之外。
- 判断型模型很适合做路由。 从 N 个选项里挑一个——或者判定都不合适——正是 Jev 为之而生的任务。它只为收到的选项文本付费,而且用概率作答,于是拒绝变成一条可以记录、可以调整、可以重标的阈值,而不是只能整套重问的 prompt 行为。
- 只要调用方需要拒绝能力,Choice 就必须带 none 选项,而且选项列表必须完备且互斥。 调用方只能看到那张表上的概率,所以它要据以行事的每一种结果都要有自己的选项、彼此不重叠,逃逸出口也是其中之一。没有 none 选项时模型照样会作答——只是它必须点一个赢家,第一版就是这样误拒了 8 道本该回答的题。
下面就是这些数字背后的 100 题测评:我们量了什么、为什么流水线是一次调用而不是两次,以及哪些实验失败了。
noul 还是 Choice
Jev 针对一个 state 回答带类型的 question,一次往返(jev.mjs)。三种类型里和这里有关的是两种:
- noul 是一道是/否问题,答案是一个概率。 各 noul 彼此独立——一次调用问 141 个,概率加起来是多少就是多少(这里平均 1.78)。可以按概率排序,但没有「唯一最优」的概念。
- Choice 是对你给的选项的分布,总和恒为 1。 它永远有赢家——即使每个选项都不合适;除非你给它那个选项,否则它永远不会说「都不合适」。
这决定了整个设计。要不要拒绝由调用方判断,所以请求是对未安装技能的一次 Choice,外加一个选项 none_of_these;决策只读一个数字——none 的概率,门设在 0.15。141 个 noul 的版本排得一样好,但 token 贵 2.4 倍(21.4k 对 8.8k),因为它要把问题模板每个技能重复一遍,而不是把选项表写一遍。
这里有一条结构性的规则:Choice 的调用方只能看到选项表上的概率,所以那张表必须完备且互斥——调用方要据以行事的每一种结果都要有一个选项、彼此不重叠,逃逸出口也是其中之一。(一个 Choice 最多 255 个选项,none 占一个,256 直接返回 400——option-limit.mjs。超过 254 个技能就分块。)
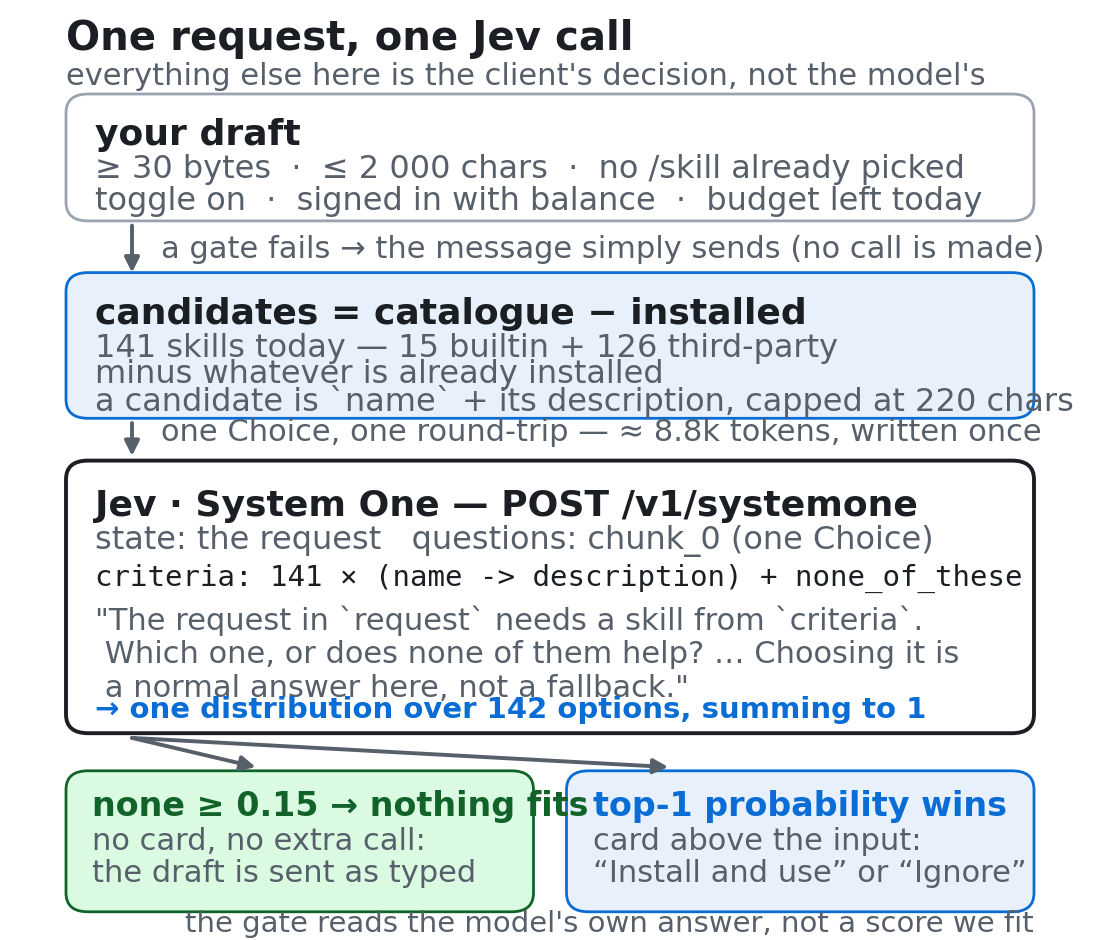
发布的路径。模型只回答一道 Choice;这一页上其余决策都归客户端。
这次调用是 agent 里的一个 RPC:suggest_skill(mod.rs);桌面端、TUI、移动端各自管触发规则,各自维护每天三张卡的预算。
为什么一次调用,而不是两次
直觉上的做法是有第二次调用做复核:先路由,再把前几名候选带上更多上下文问一遍。我们做过,分数确实更高——95.4% 对 90.8%——因为第二次调用能读到技能文档,而选项表里没有。但它背后的数字是:
- 在它被触达的题目上,95% 只是在确认第一次调用的答案——纠正只有 3/65;
- 它自己的拟合阈值在 100 道题里一次都没触发过——拒绝本来全是那道门的事;
- 它要多付每次请求一次网络往返(p50 从 488 ms 涨到 772 ms)加 10% 成本;
- 而它赢的三道题里有两道,赢在题目措辞与技能文档重合、只有第二次调用能读到——这是收益的上界,不是期望值。
三道题,换每个请求多一次往返、多一种失败模式,以及一个把收益吹大的偏差。这就是服务路径只有一次调用的原因。
测评量到了什么
65 道应该由某个技能服务的题(从每个技能自己的 SKILL.md 生成,机器检查保证不出现技能名),加 35 道不该服务的。参考答案来自一个强生成模型,它看不到题目是从哪个技能生成的;只评第一个答案。
- Jev 没赢过生成模型,这个题量上也分辨不了。 同一份 Jev 代码跑三次,在 90.8–93.8% 之间浮动;95.0% 对 93.0% 的决策一致率差距落在噪声之内。Jev 多出来的是一条可以标定、可以记录、可以重调的拒绝。
- 向量检索不会拒绝。 余弦相似度永远有最近邻;拟合出的阈值给 71.4% 的正确拒绝和 16.9% 的误拒。适合打字时的即时召回,不适合做决定。
- 成本就是那张选项表。 描述多一个字符,就是 141 个技能各多一个字符:每天 10 万次推荐,约 ¥266/天对 ¥2,490/天。
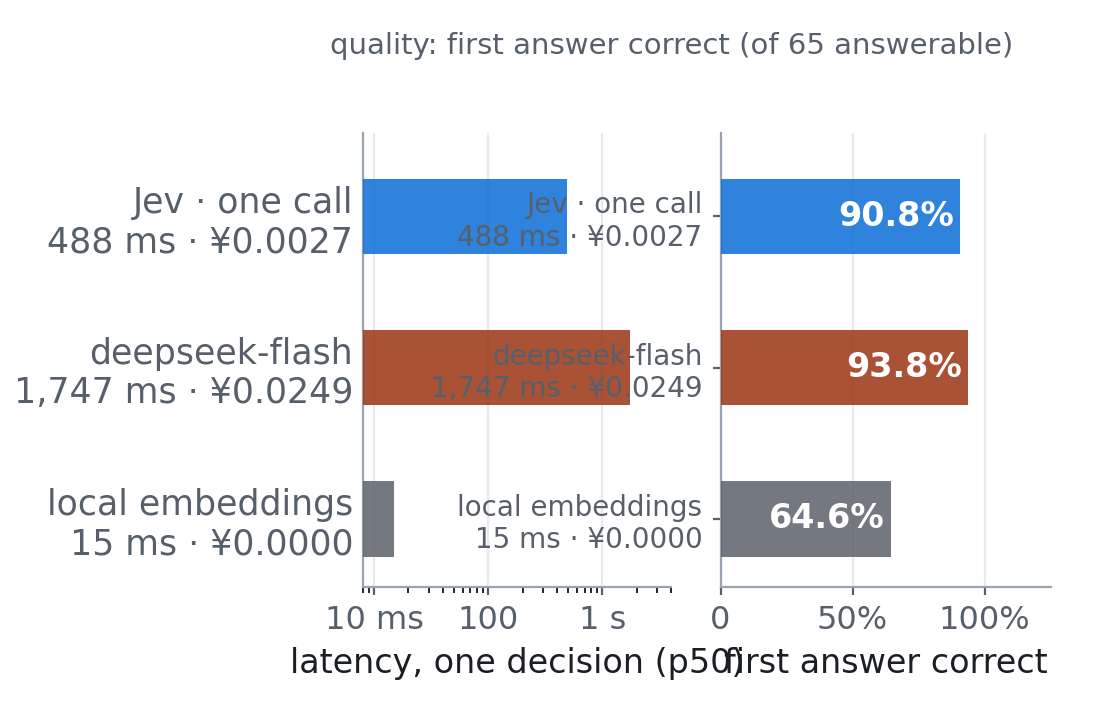
同样 100 道题、同样的 prompt 和同样的清单。向量检索一行根本不会拒绝;生成模型的拒绝是 prompt 行为,只有 Jev 的拒绝是一条阈值。
prompt 在局部最优点上
14 个变体、四个批次,放在同一个请求里对比——作为共享同一份 state 的多道 Choice——因为同一份代码在两次运行之间就会在约 9% 的题上改答案,否则每一次措辞实验看起来都像进步。没有变体赢过现在的措辞。两句话是承重的:删掉「Choosing it is a normal answer here, not a fallback.」,正确率不变,拒绝率却从 97.1% 塌到 85.7%——模型需要一句明确许可才敢选「都不用」;去掉问题里「needs a skill」的预设,要付出两次拒绝。
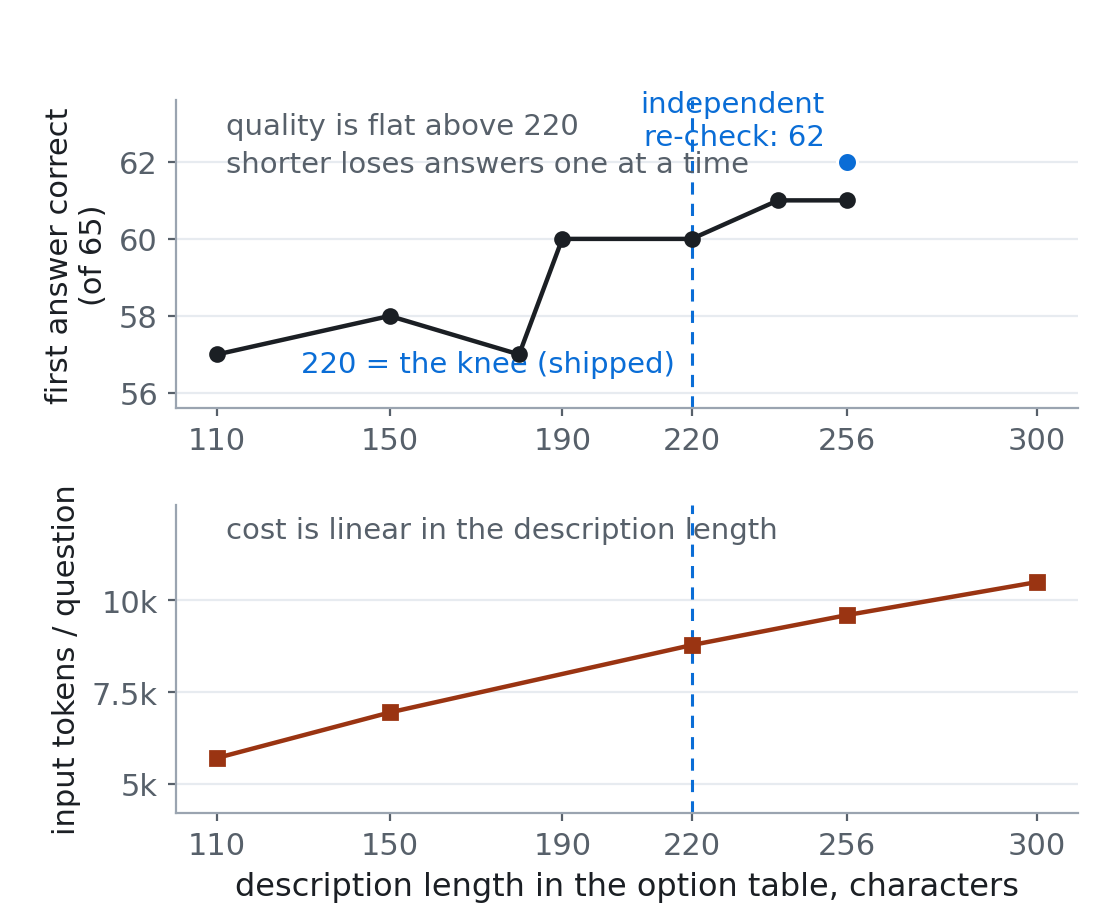
质量从 220 字符起走平,成本继续线性上升。220 就是拐点。
还有一个负面结果。两个额外选项看起来很自然——「多个都合适」和「我需要的技能不在这个列表里」(escape-options.mjs)。前者在 100 道题里一次都没被选中,也没东西可修(多技能参考答案的题本来就 12 道全中)。后者用得准确,但只出现在门本来就拒掉的题上;它唯一的净效果是从 none 身上拿走概率质量,放行了 1 条错误推荐。门读的是 none 在一个总和恒为 1 的分布里的份额,所以加一个选项就会悄悄重标定你唯一的拒绝信号。
在产品里的样子
卡片会扣住草稿等你决定:「Install and use」追加斜杠命令,「Ignore and send」按原样发出——卡片还在时直接发送,效果相同且不再多调一次。客户端截止时间是 3 秒(原来 1.5),因为 Jev 的 p95 约 1.4 秒,被丢掉的答案看起来和「没有合适的技能」一模一样。每日预算只统计展示出来的卡片,不统计调用。还有一个值得记录的 bug:TUI 里候选集合只在 /skills 面板打开时加载,所以新会话会沉默地拒掉每条消息——「接上了」和「能用」是两回事;现在它在你打字时预取。
完整测评、那 100 道题、以及这篇文章里每个数字对应的脚本都在 skill_reco/ 里——包括失败的实验,否则它们注定被重跑一遍。