实测上下文压缩:FutureOS vs Codex vs OpenCode
一个长 agent 会话会把上下文窗口填满。总得有东西被扔掉。每种压缩策略对同一个问题给出不同答案:你留下什么?
我们测了三种答案——FutureOS 的默认策略、OpenCode、Codex——用同一个模型、同一组问题、同一种调用形态。唯一变量是一次压缩留下什么。下面全部内容都可以用 FutureOS 仓库里 compaction_experiment/ 复现。外部实现固定到 Codex b13164d8 和 OpenCode e03db9bc(包 1.18.31);之后的提交会让这些数字失效。
实验
把一个会话养到上下文满。强制一次压缩。然后问 178 道只能靠记忆回答的题——某个脚本输出的第三行、某个工具返回的 ID、用户几小时前定下的约束。其中 8 道是诱饵题,答案从未在任何地方出现过,用来抓那些靠猜的系统。
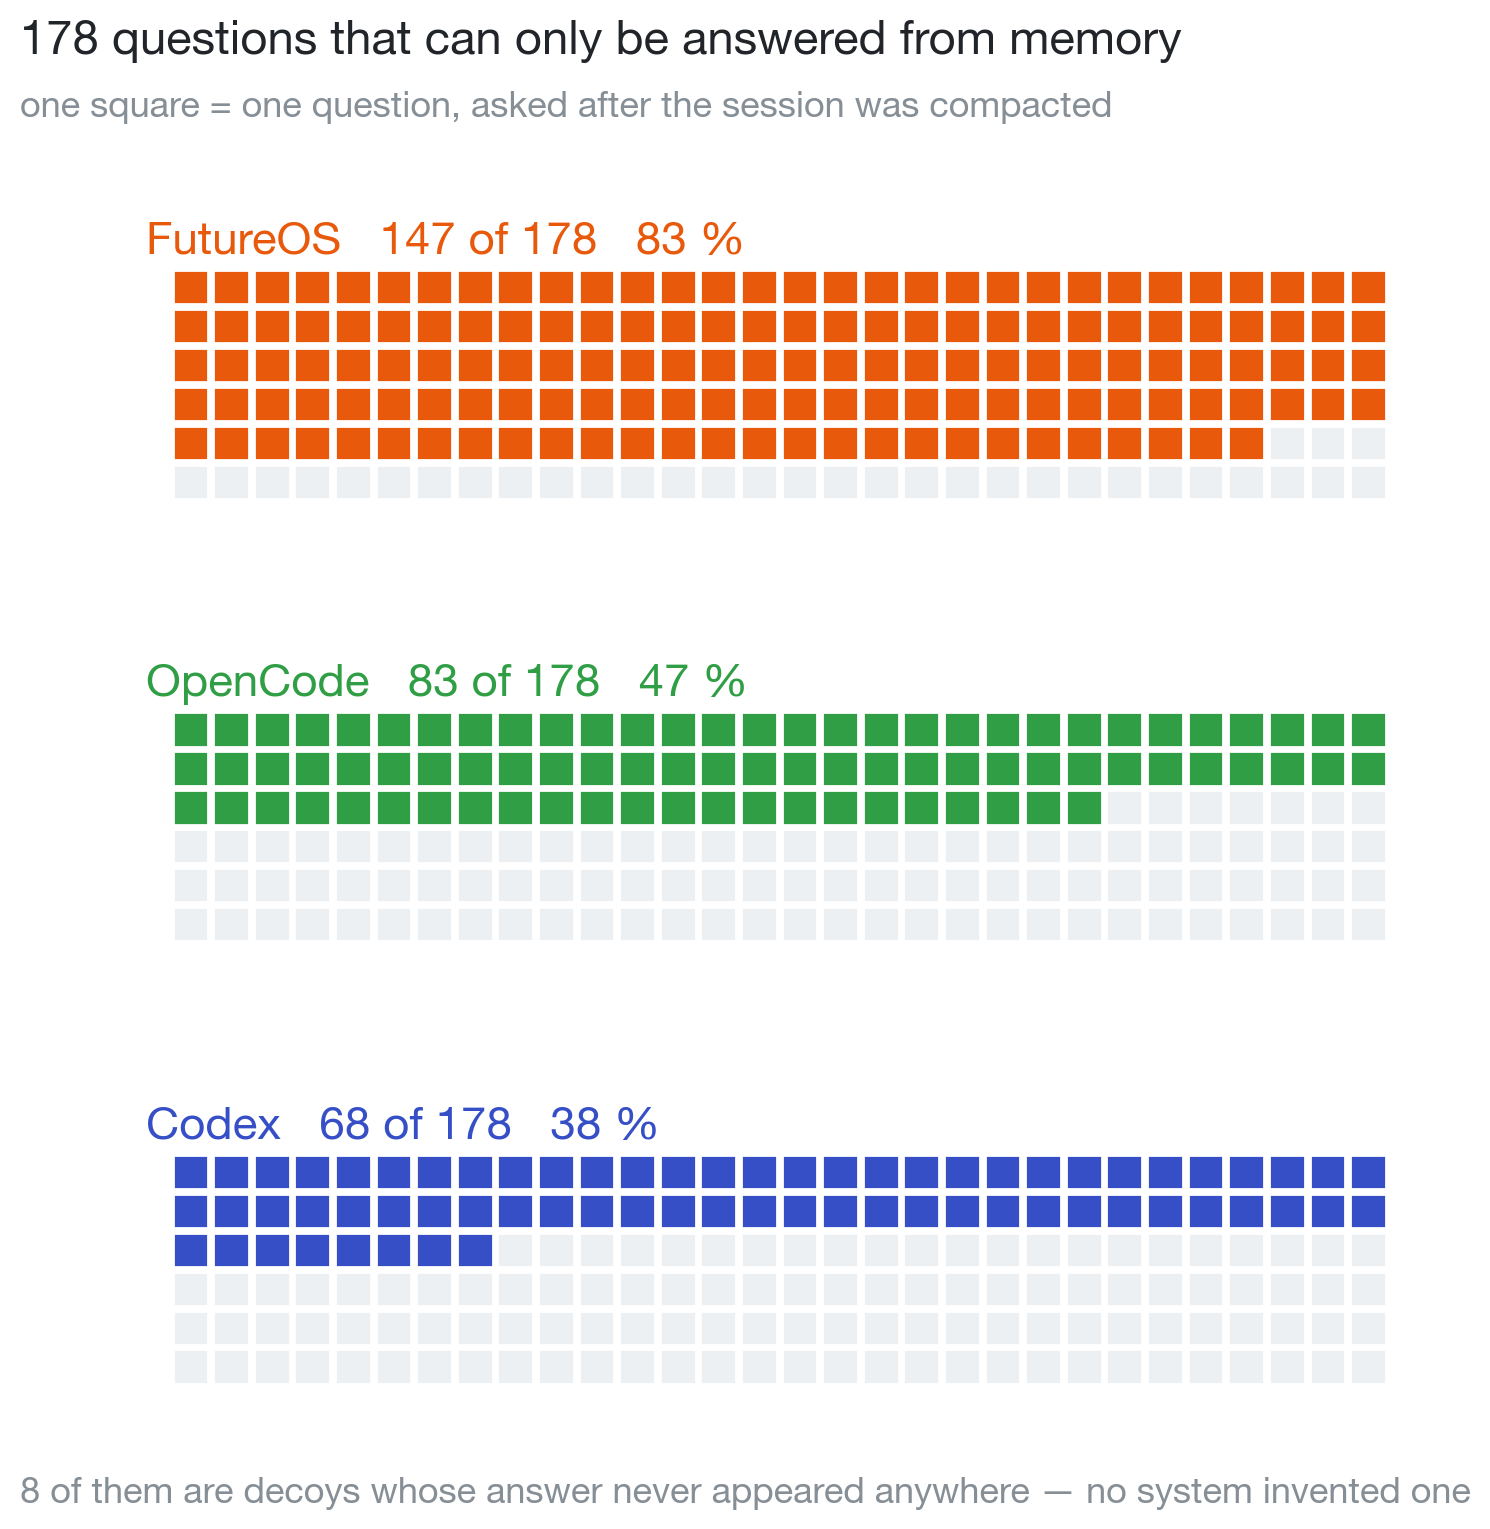
图 1:178 道题,以及压缩后每个系统还能答出多少。
FutureOS 保住 147 道(83%)。OpenCode 保住 83(47%)。Codex 保住 68(38%)。没有一个中诱饵。
差距不在于谁摘要写得更好。在于三个系统对「压缩」的理解不同:
| 它认为应该留下什么 | |
|---|---|
| Codex | 用户说过的话。全部用户消息(上限 20,000 token)加一份全历史摘要;助手正文和工具输出直接丢弃。 |
| OpenCode | 一份摘要加一段近期尾巴(上限 15,000 token)。细节被期望活在摘要里。 |
| FutureOS | 原文。受保护的用户与助手原文优先;摘要和工具证据索引是对装不下部分的补偿。 |
摘要是有损的,你也没法验证它丢了什么。Codex 走得更远——它压根没打算保留 agent 自己的输出。是这个选择,而不是摘要质量的差别,决定了分数。
上下文里到底有什么
压缩是个预算问题。先弄清窗口是被什么填满的。我们统计了五条冻结的真实会话链:
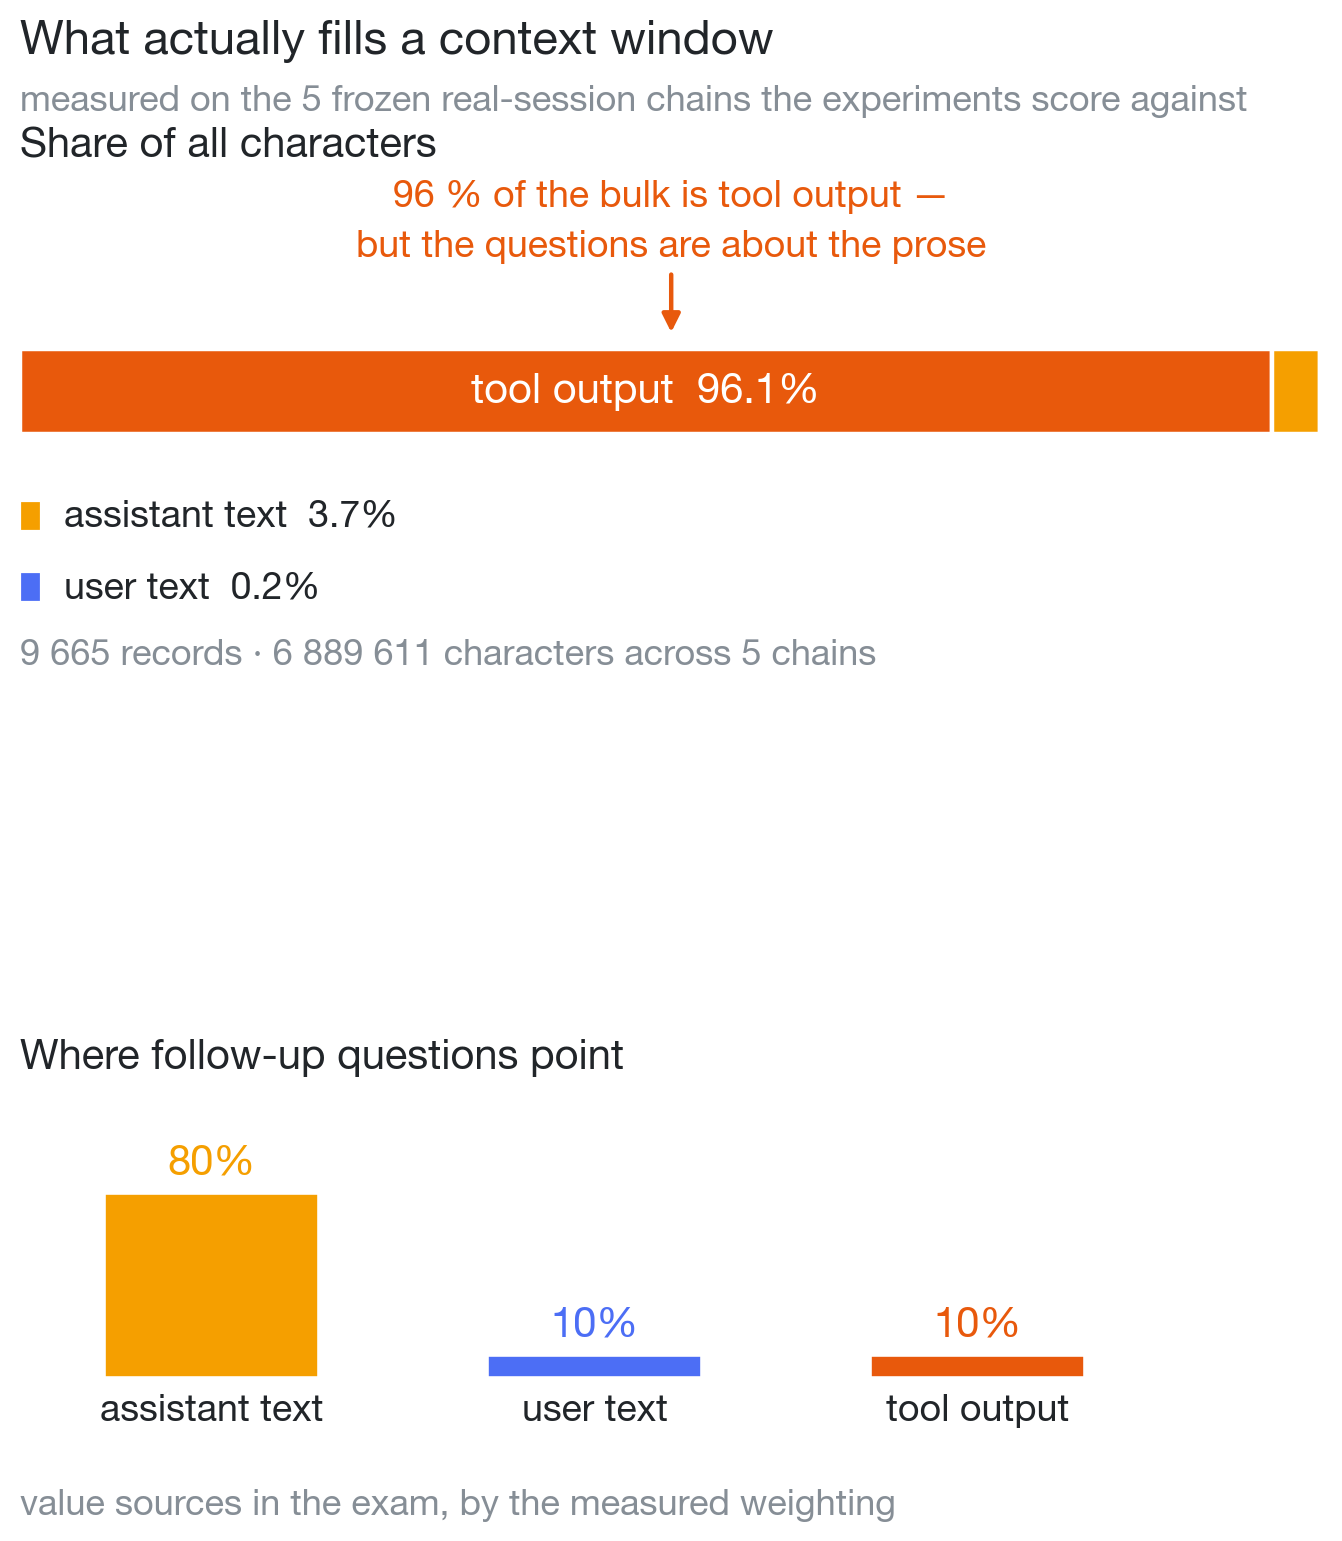
图 2:左——什么填满窗口;右——后续问题指向哪里。
| 记录类型 | 记录数 | 记录占比 | 字符数 | 字符占比 |
|---|---|---|---|---|
| 工具输出 | 4,370 | 45.2% | 6,622,624 | 96.1% |
| 助手文本 | 784 | 8.1% | 256,060 | 3.7% |
| 用户文本 | 141 | 1.5% | 10,927 | 0.2% |
| 工具调用(参数) | 4,370 | 45.2% | — | — |
9,665 条记录,6,889,611 字符。每条链里工具输出占字符的 99.4% / 98.4% / 96.8% / 96.7% / 93.2%——从没低于 93%。
窗口是被工具输出填满的,不是对话。你和模型互相说的话加起来才 3.9%。但当有人问「之前发生了什么」时,80% 的这类追问指向助手自己说过的话,用户轮次和工具输出各占 10%:
| 体积占比 | 问题占比 | |
|---|---|---|
| 工具输出 | 96.1% | 10% |
| 助手 + 用户文本 | 3.9% | 90% |
这个错配就是整张设计的一张表。工具输出按体积几乎是全部、按引用几乎为零,所以可以压成路标。正文按体积很小,却是 90% 问题指向的地方,所以压它几乎省不下什么,却恰好丢掉人们会问的部分。
这么读,上面的损失就说得通了。Codex 和 OpenCode 把正文和工具一起压。Codex 完全不保留助手文本,按构造放弃了 80% 的问题;OpenCode 把正文折进摘要,有损。83% 对 38% / 47% 的差距,大部分来自这一个决定。
各自擅长什么
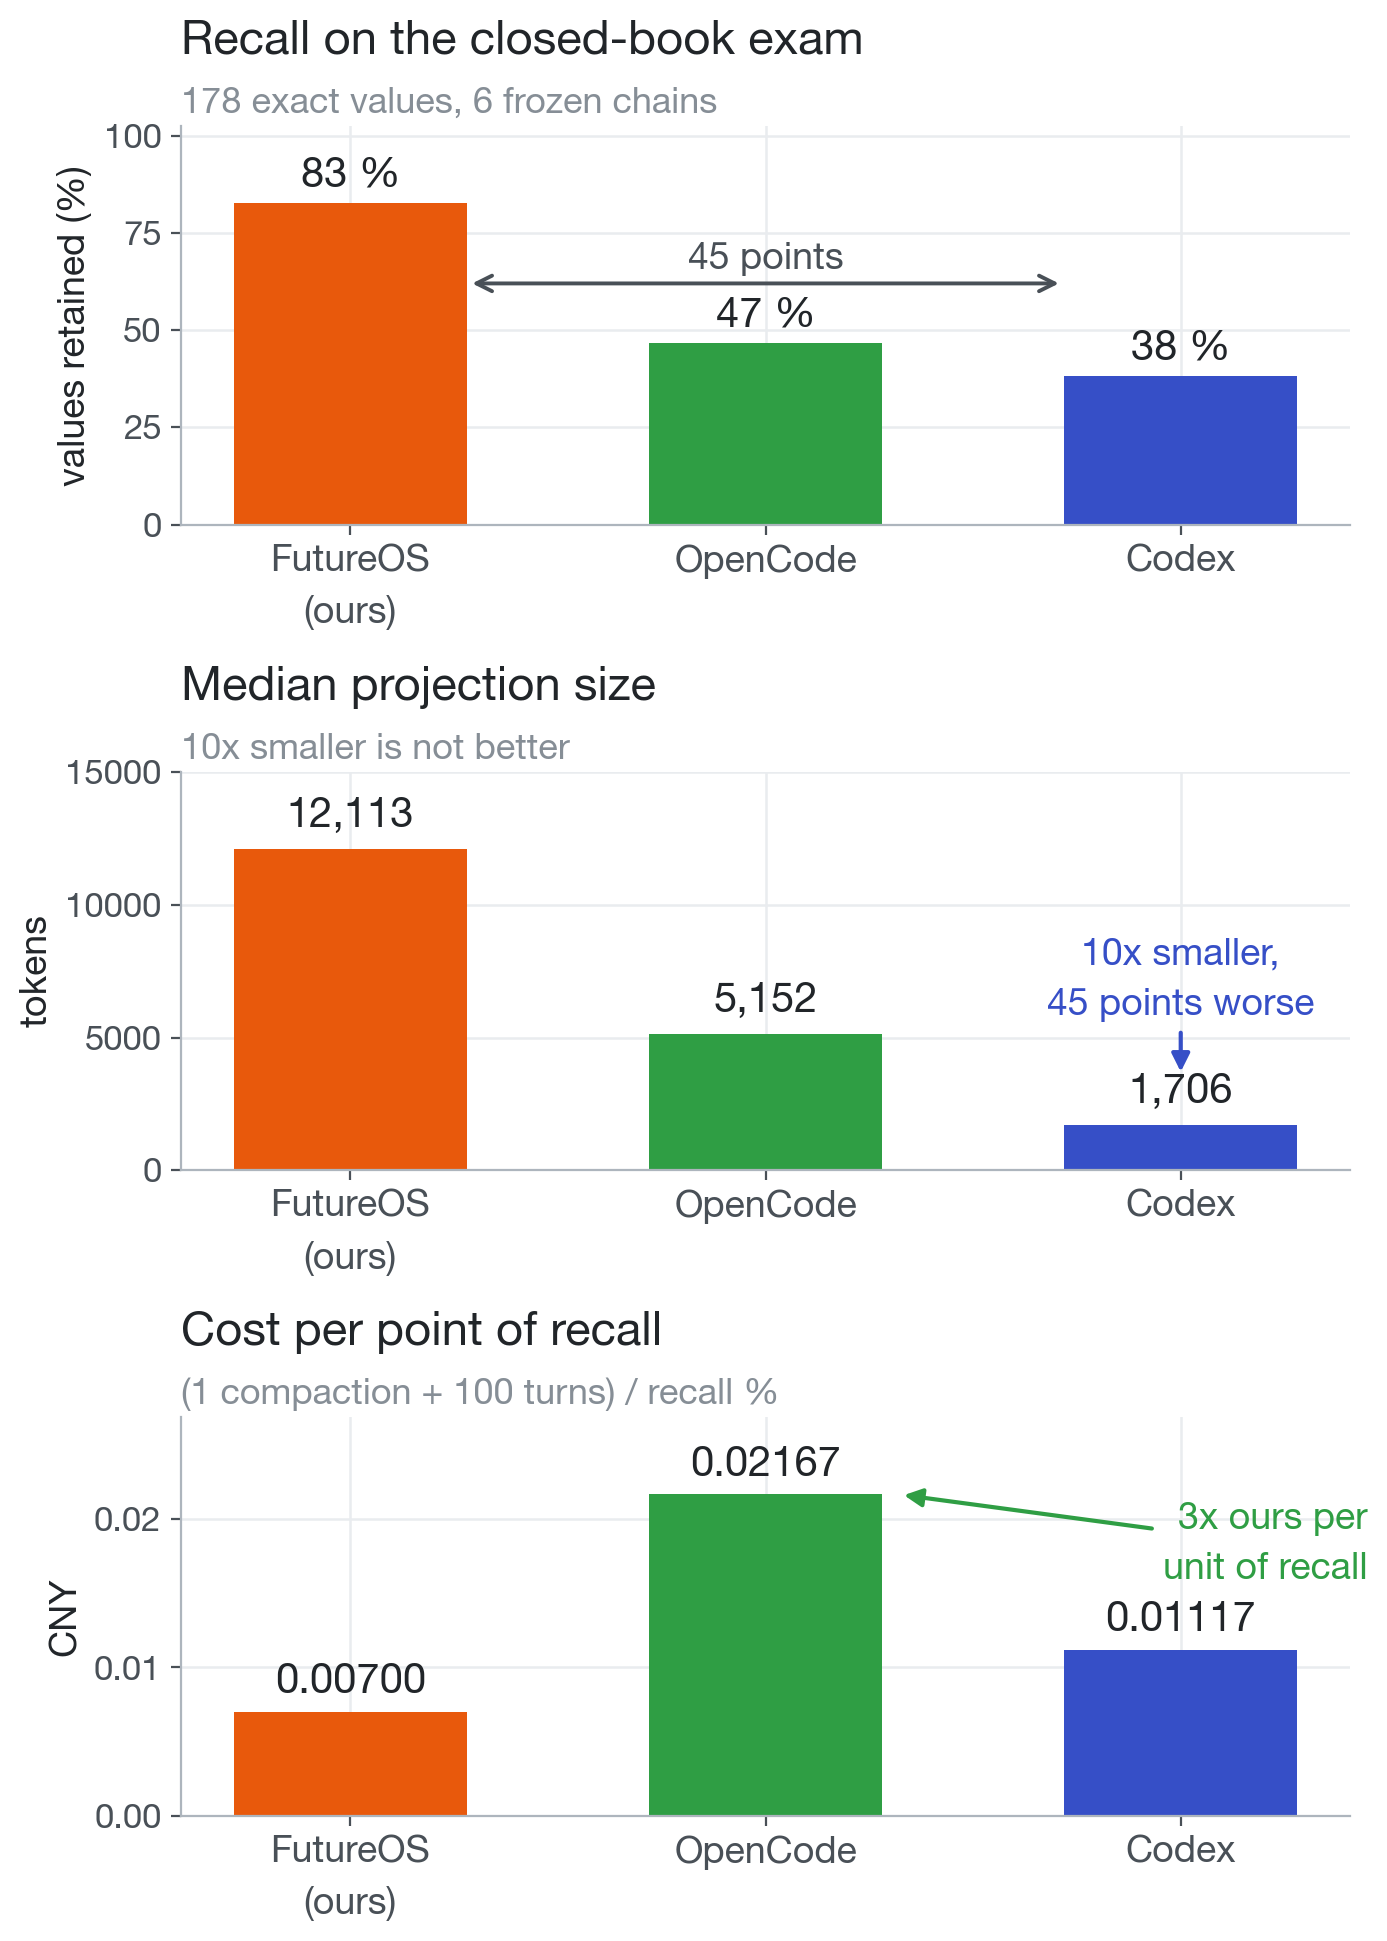
图 3:左——保留了多少信息;中——花了多少 token;右——每一点召回背后的钱。
| 策略 | 召回 | 中位投影 | 压缩率 | 压缩(冷/缓存) | 每轮 |
|---|---|---|---|---|---|
summarized(我们的,默认) |
147/178 (83%) | 12,113 tok | 5.7% | 7.98 / 0.53 | 0.000480 |
deterministic(我们的,无模型调用) |
127/178 (71%) | 9,945 tok | 4.7% | 0 / 0 | 0.000394 |
opencode |
83/178 (47%) | 5,152 tok | 2.1% | 0.99 / 0.99 | 0.000204 |
codex |
68/178 (38%) | 1,706 tok | 0.6% | 7.64 / 0.42 | 0.000068 |
| (不压缩) | — | 232,777 tok | — | — | 0.009219 |
成本是人民币;每轮 是之后每一轮重发该投影的成本。
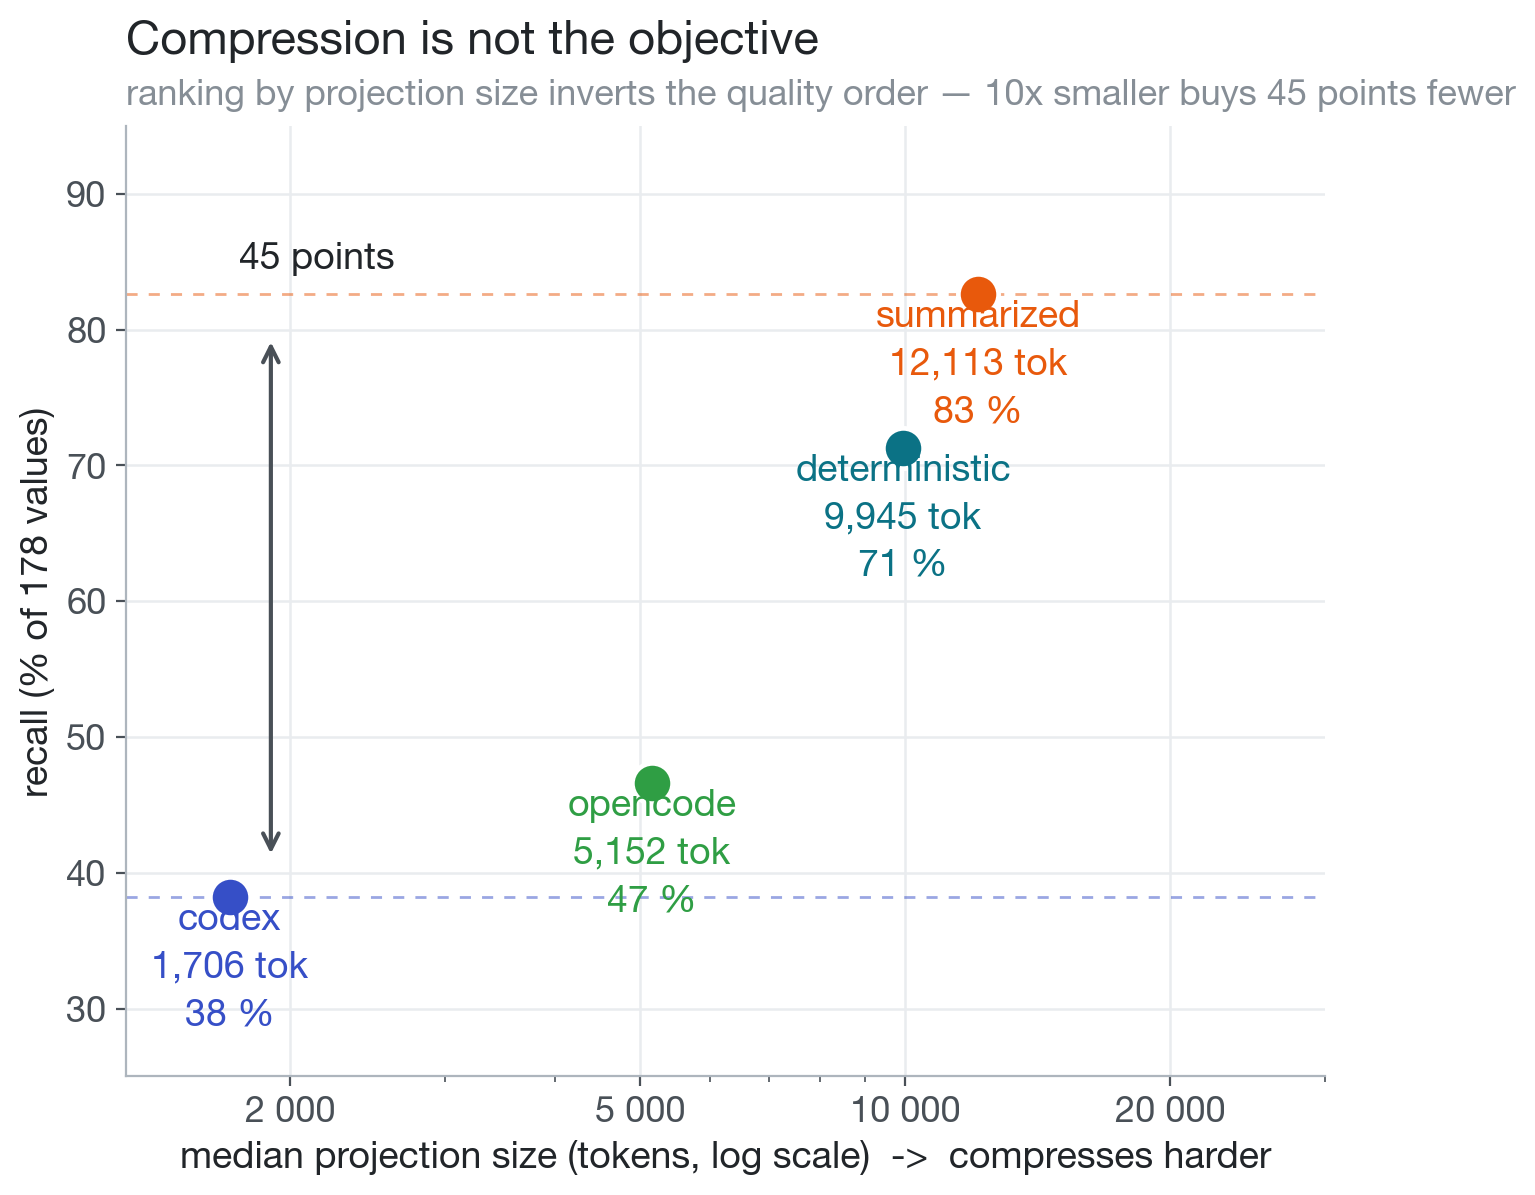
图 4:x 是投影大小(对数),y 是召回。这里压缩率与质量负相关。
Codex 最便宜。投影最小、每轮最便宜、回本最快(46 轮)。它的压缩请求共享前缀,所以 ¥0.42 就能压缩一次。代价是保留范围——没有助手正文,没有工具输出。
OpenCode 是均衡的那个。摘要加尾巴保住了三类信息的一点(47%、5,152 token),专门的压缩系统提示把压缩逻辑挡在会话提示之外。它放弃了前缀共享(一口价 ¥0.99),摘要也仍然有损。
FutureOS 保留最多。原文优先换来 83%,而且因为摘要请求复用会话自己的系统提示和工具定义,仍能命中前缀缓存(生产实测 99.8%),于是 ¥7.98 冷变 ¥0.53。deterministic 档完全不调用模型——零成本、71% 召回。代价是投影最大、每轮最贵:我们花 token 买召回。
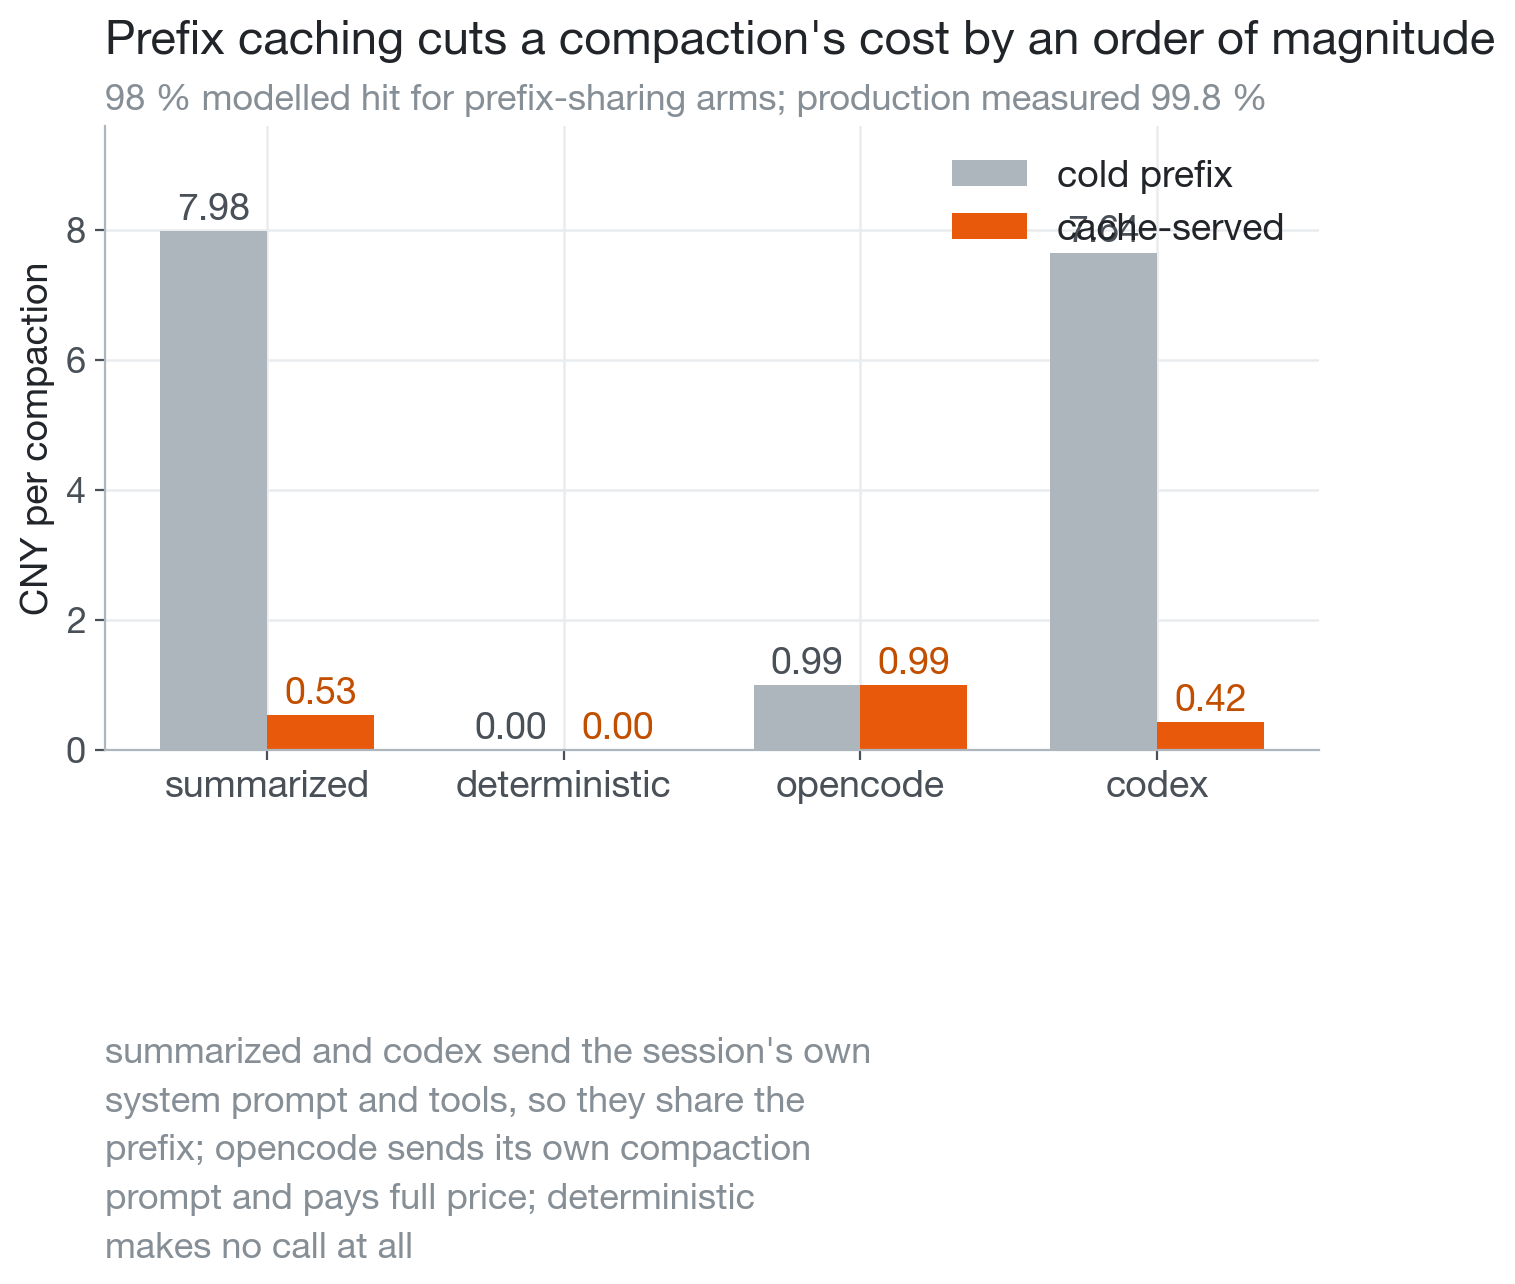
图 5:压缩成本,冷 vs 缓存命中。
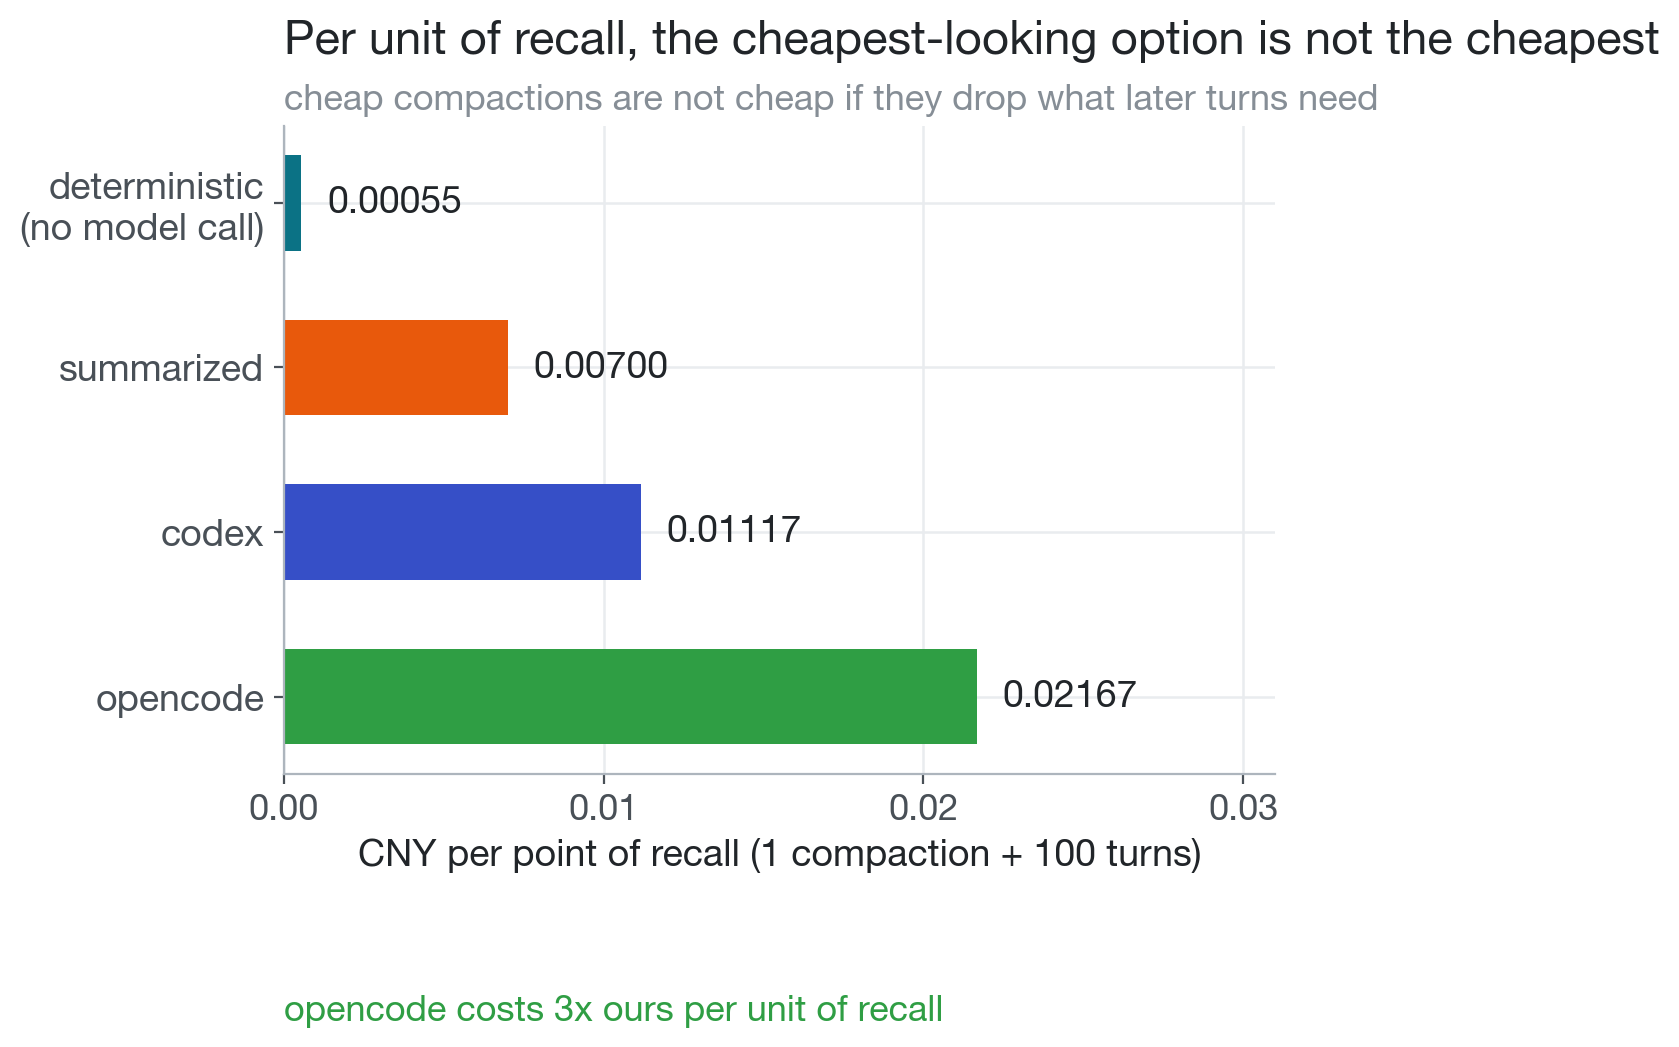
图 6:一次压缩加 100 轮,每点召回的成本。
缓存把价格压了一个数量级:¥7.98 冷对 ¥0.53 缓存——15×——这把「比 OpenCode 贵 8 倍」变成「是 OpenCode 一半价」。按每点召回算,三方是 0.0070 / 0.0112 / 0.0217(FutureOS / Codex / OpenCode)。一次便宜的压缩如果丢掉了后续轮需要的东西,就不算便宜。而且压缩要靠几十轮才回本(summarized 61 轮、codex 46、opencode 110);对短会话它是净成本,买来的是召回和余量。
⚠️ 缓存数字是建模的,不是实测:这几轮自己的缓存计数器被臂和运行顺序污染了,所以 98% 锚定在唯一那次生产实测(99.8%)上。
我们的压缩怎么工作
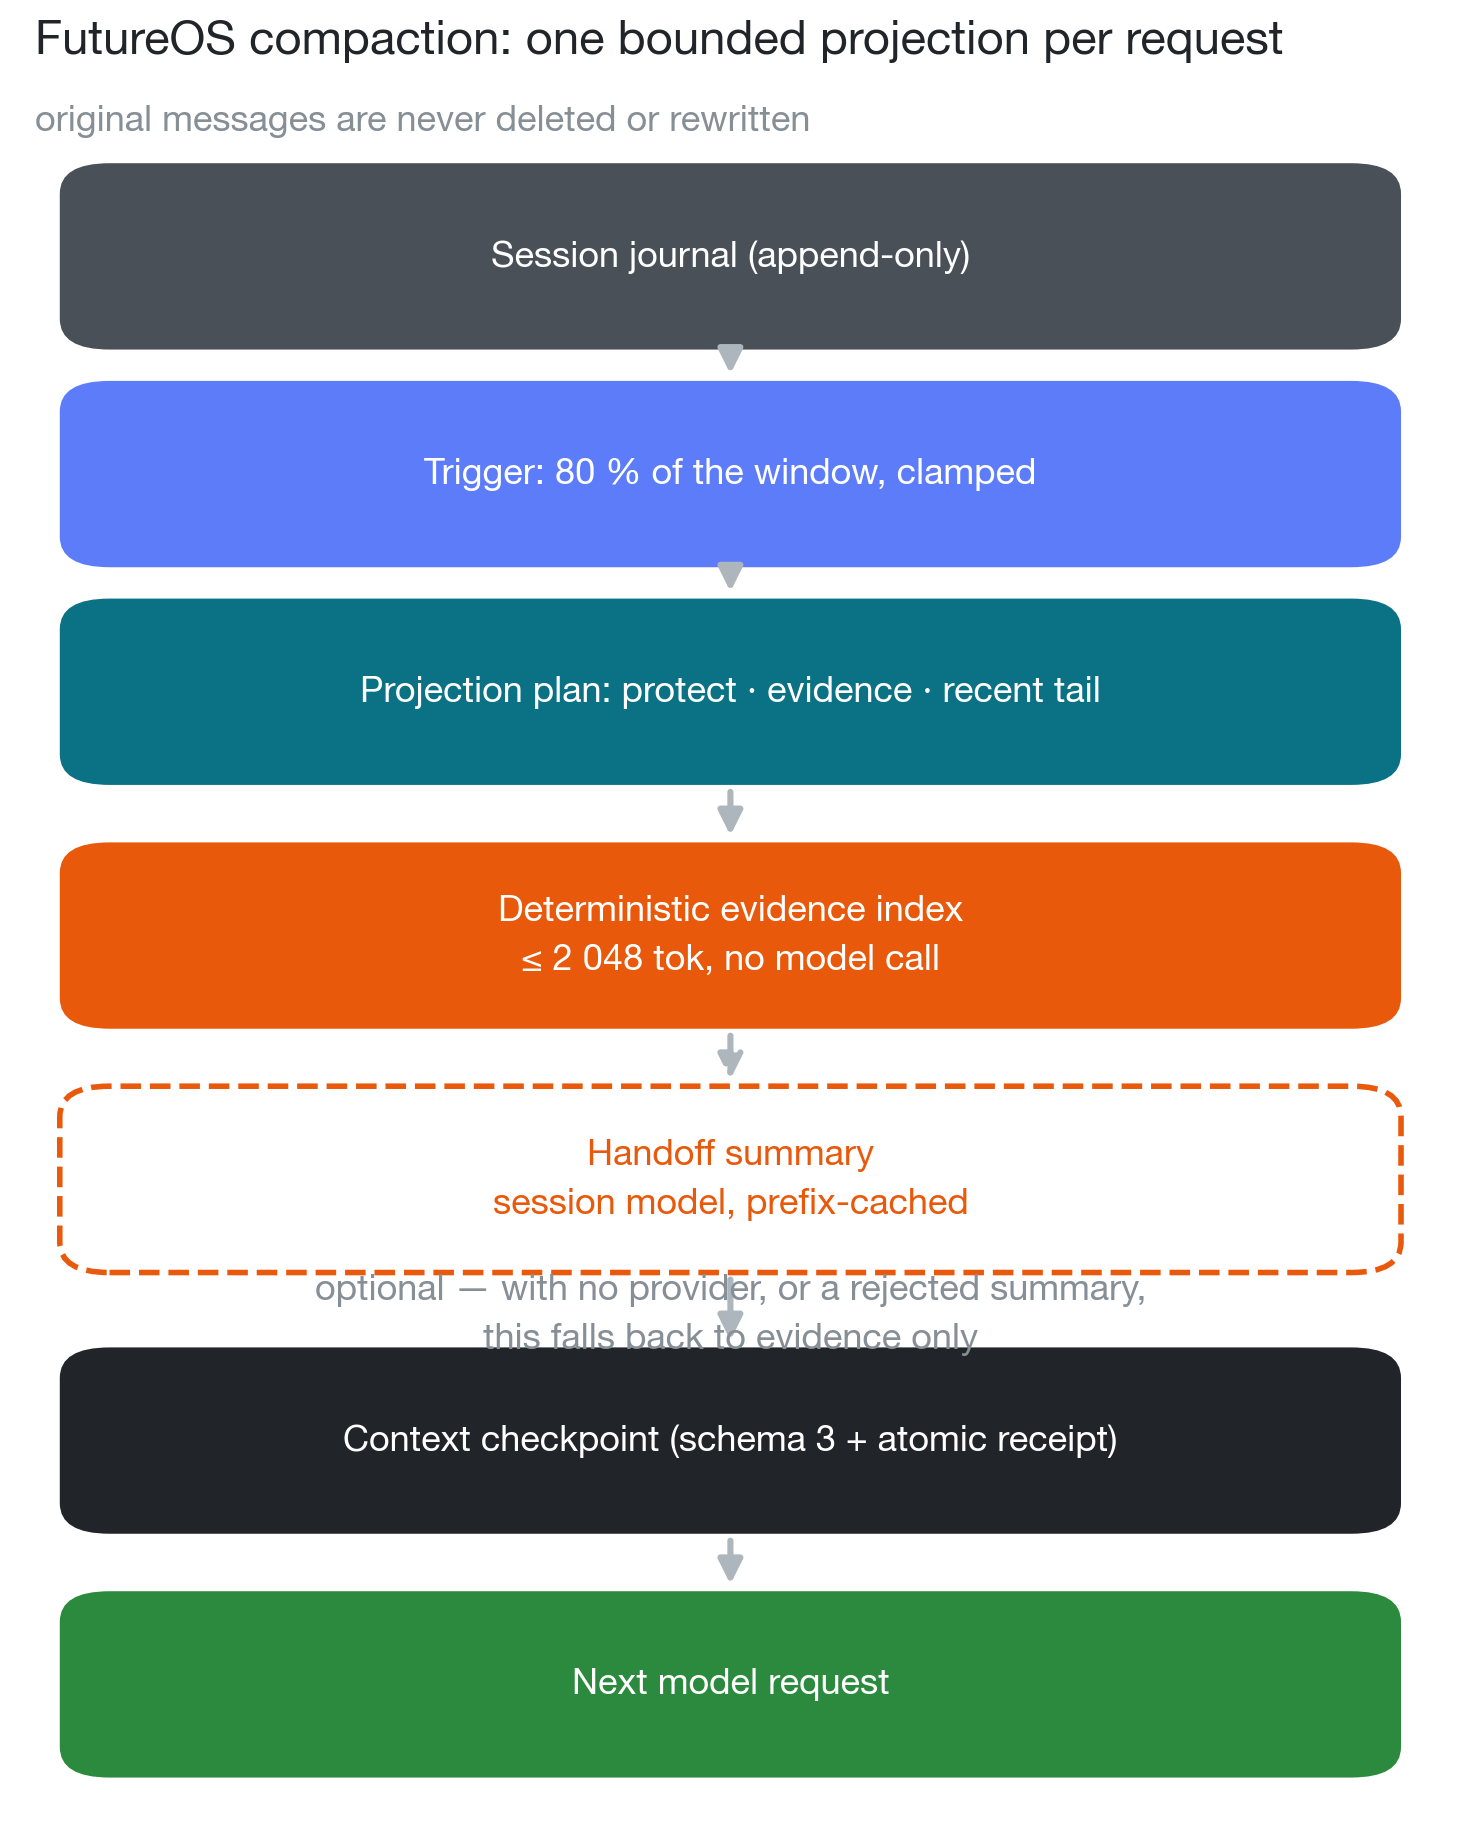
图 7:一次完整投影。原始消息从不删除、从不改写;压缩只改下一次请求看到什么。
关键词是投影。压缩不删除 journal、不改写历史;它只为下一次请求重算模型能看到什么。原文留在磁盘上——可搜索、可导出、可分叉。
有两个算法和一个回退。algorithm_version 恰好写两个值:deterministic-(受保护原文 + 近期尾巴 + 确定性工具证据索引,无模型调用)和 summarized-(同上加一份交接摘要,一次模型调用)。summarized 是默认;deterministic 也是回退——联系不上 provider、或摘要失败时,提交确定性投影。
触发器在每个模型步之前跑:
economic_trigger  = floor(W × 0.8)                      # 1M 窗口 -> 800,000
effective_trigger = min(economic_trigger, W − O − margin)
margin            = min(2048, W / 16)
O 是模型声明的输出上限;min 意味着一个为大输出保留空间的模型被它自己的限值约束,而不是一个固定数字。输入还装得下就什么都不剪。
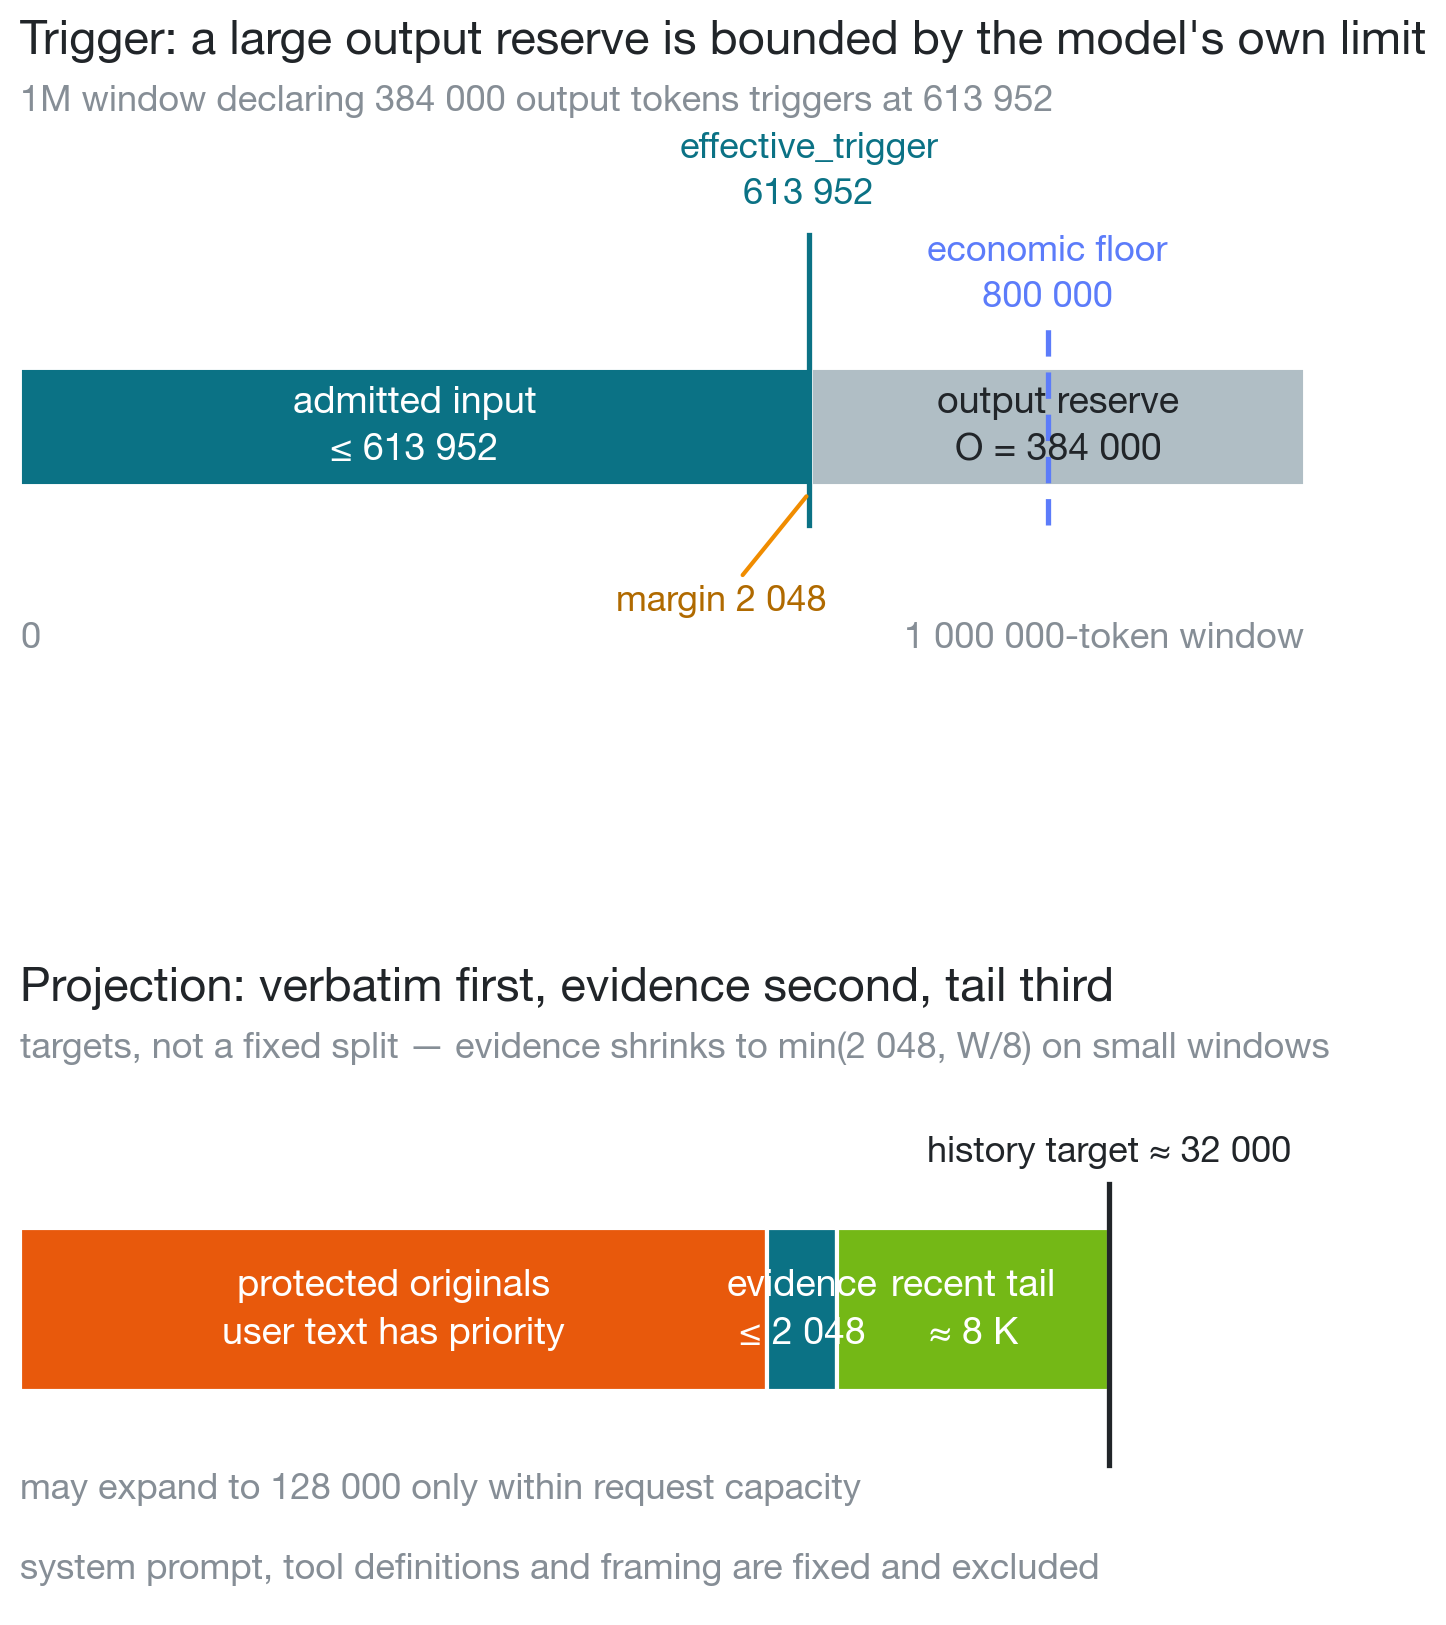
图 8:上——触发器如何推导;下——投影内部的目标预算。
投影里有什么:用户文本永远保留,剩余空间优先给助手原文。工具输出压成一个 2,048 token 的证据索引,保留约 8K token 的近期尾巴,历史目标约 32K(至多 128K,绝不越过真实容量)。被降级的助手输出标注为「omitted / not summarised」——绝不包装成摘要——其原文仍可查询。
为什么用户文本赢?用户约束和目标无法重新生成;工具输出和助手正文通常可以从原文重新生成。这是信息可恢复性的论证,不是公平的论证。
证据索引完全确定性——无模型调用。错误结果优先;再按工具和目标分组,优先 config / schema / validation / test 类目标;每组取最新和最早;剩余空间按时间近远。每条被选记录变成一条有界 JSON 行(entryId、blockIndex、sourceOrder、tool/sourceOrder 保持时序可见,旧错误不会被误当成当前的。
摘要请求没有单独的提示,这是刻意的。provider 的前缀缓存从 token 0 开始比对:[系统提示][工具定义][消息…]。只要这三段和驱动请求的会话一致,整段前缀就走缓存——所以摘要请求带着会话自己的系统提示和工具定义。在预热前缀上实测:形态一致 93.7% 缓存命中;换系统提示 0%;丢工具定义 0%;加一行 0%。真实路径上,一个养到 212,911 token 的会话压缩时 cache_read = 212,548——99.8% 来自缓存,¥0.003 对 ¥0.53 冷。(缓存读比新输入便宜 50×:每 1M token 0.02 vs 1.0。)
检查点是幂等的。一次压缩与它的完成回执原子提交;由退役算法写出的检查点根本不算检查点,会被重新覆盖一次;同 key 的成功直接复用、不再请求;未完结的 started 操作保留它的并发栅栏——不抢认领、不伪造成功。
检索能补回损失吗
如果原文都还在,为什么不让模型去查?我们跑了开卷考试:一臂、summarized、18 个用例、178 个值。
| # | 改了什么 | 设计 | 召回 | 工具调用 |
|---|---|---|---|---|
| — | (闭卷基线) | 无工具 | 147/178 (82.6%) | 0 |
| 1 | 生产提示 + 工具 | 自主 | 148/178 (83.1%) | 0 |
| 2 | + 更强的召回引导 | 自主 | 149/178 (83.7%) | 0 |
| 3 | + 不再把投影称作「记录」的措辞 | 自主 | 145/178 (81.5%) | 0 |
| 4 | 按第 3 轮措辞重评闭卷(对照) | 无工具 | 147/178 (82.6%) | 0 |
| 5 | + 显式验证指令,强制首次调用 | 强制 | 166/178 (93.3%) | 100 |
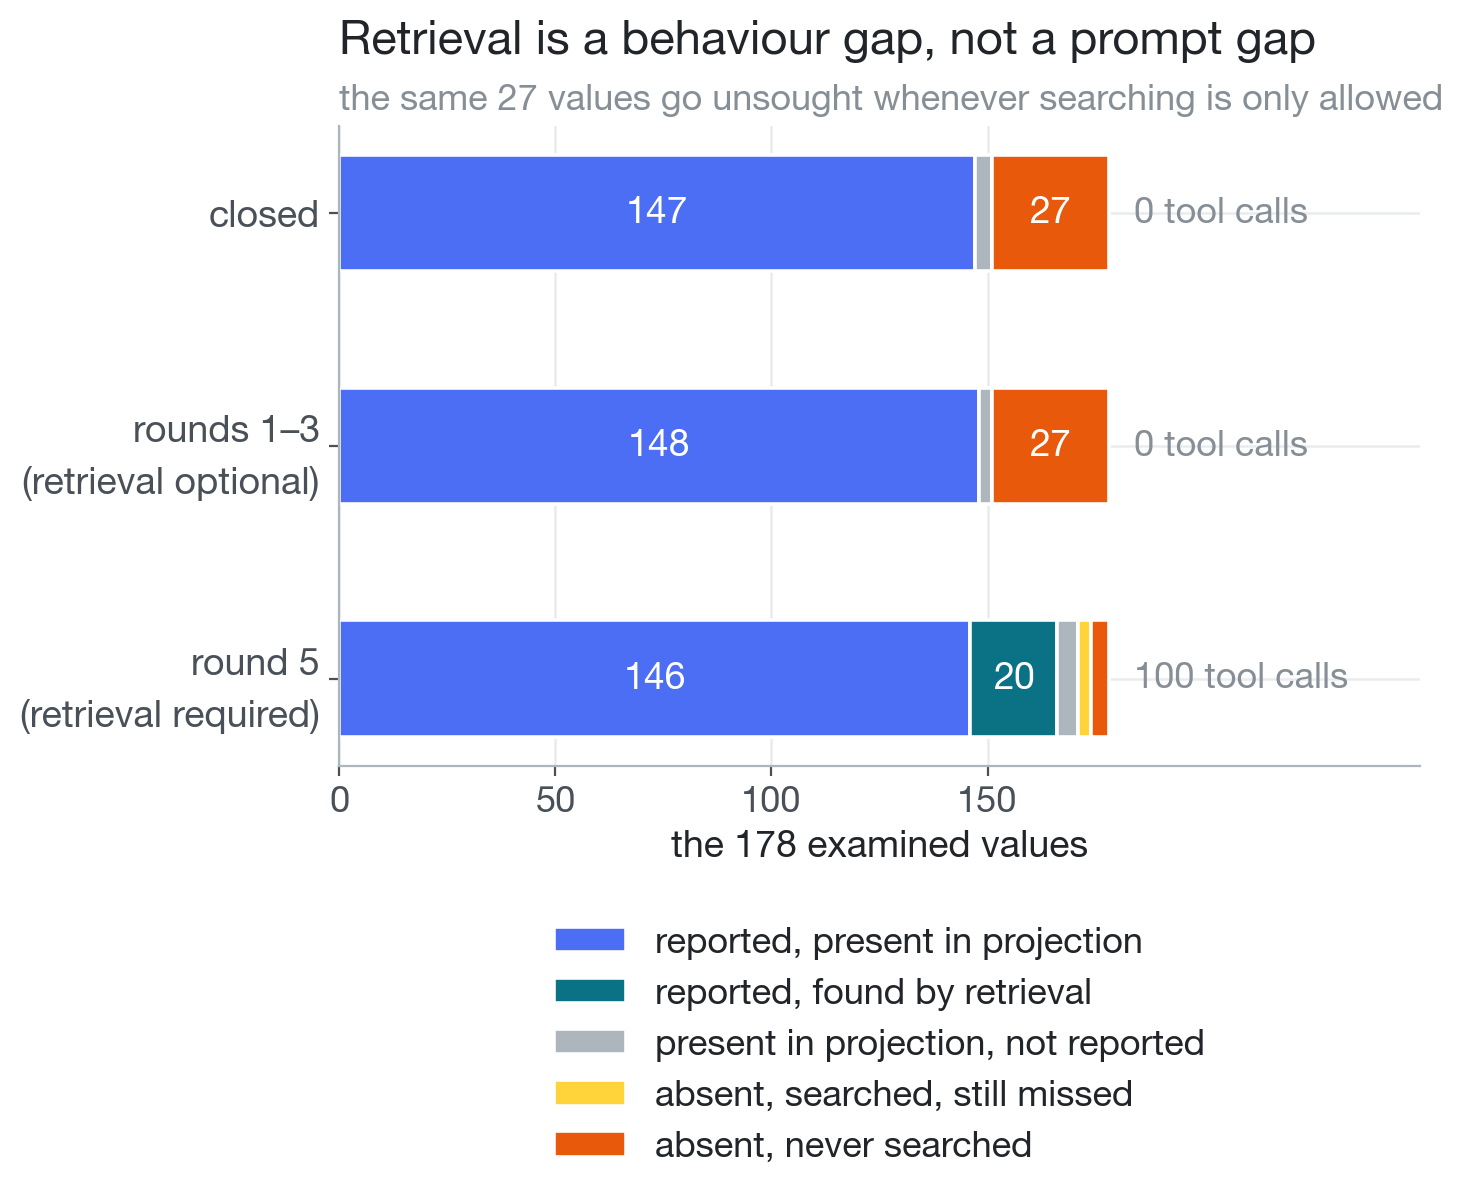
图 9:178 个值去了哪。那 27 个橙色在每一轮「只允许搜索」里都恒定——模型就是没去查。
第 1–3 轮是同一个结果测了三遍:零次工具调用,145–149 的散布是 178 个值上一次翻转的噪声。第 4 轮是第 3 轮的对照——如果措辞改动影响了分数,闭卷臂会跟着动;它没有(两种都 147)。那 27 个恒定:值在归档里,模型从没去查。强制轮通过搜索找回了 28 个缺失值里的 20 个——所以差距是行为上的,不是能力上的。第 5 轮是上界,不是结果:生产里没有这样的指令。
于是我们把召回引导从运行时里去掉,保留了检索 CLI(future session history search / get)。引导描述的是模型本来就有的一项能力,而把它描述得更坚决并不能让模型去用——三个变体、54 个用例、零行为改变。一个有用的副作用:会话的系统提示在检查点提交时不再变化。
要点:检索补不回保留范围的差距。我们的路线是把原文留在投影内部,而不是指望模型去翻。
局限
- 这场考试是再认,不是任务续作。它要精确值——这正是逐字保留最擅长、摘要最不擅长的。一场任务形态的考试可能表现不同。
- Codex 和 OpenCode 是单点重实现。它们的规则和提示是从特定提交读出来的;上游之后的改动会让这些数字失效。Codex 的一方检索工具需要它的托管后端,所以它那一列是它的本地回退。
- 合成fixture 工具很重,这奖励了携带工具证据。真正的区分出现在真实会话里。
- 每格一次抽样。几个点的差距在这个样本量下无法分辨。
- 缓存数字是建模的,锚定在一次生产实测上。
复现
# 构成统计(不用模型、不花钱)
python3 scripts/compaction_experiment/context_composition.py

# 构建驱动
cargo build -p future-agent --example compaction_probe --example model_bridge

# 从真实一轮抓取调用形态(隔离 HOME、新端口)
python3 scripts/compaction_experiment/capture_shape.py \
    --binary target/debug/future --out ~/compact-exp/shape

python3 scripts/compaction_experiment/run_closed_book.py \
    --output ~/compact-exp/v4-forced --force-compaction --budget 300 \
    --driver target/debug/examples/compaction_probe \
    --bridge target/debug/examples/model_bridge --shape ~/compact-exp/shape
输入、账本和结果放在任何仓库之外(含真实会话数据)。合成链可以从带种子的生成器逐字节重新生成;真实会话链根本无法发布,所以第三方复现那一半意味着换成你自己的会话——绝对数字会不同,但比较应该成立。引用任何数字前,先跑 verify_:它不需要模型,检查考试是否仍在发送生产环境的提示和工具。
完整方法、运行时策略和两份实验报告在 FutureOS 仓库的 docs/ 下;图表由 compaction_ 里的 sharing_ 生成。